


Войти на сайт
SDM (species distribution modelling) - метод экологического моделирования, позволяющий прогнозировать географическое распространение разных видов животных, растений и грибов.
Qb.SDM - программный комплекс, реализующий алгоритмы SDM.
Пользовательский интерфейс Qb.SDM реализован в браузере и доступен по ссылке https://wingeds.world/sdm
В этом документе находится документация к программному комплексу Qb.SDM и общее описание алгоритмов SDM.
1. SDM: моделирование распространения видов.
1.2. Ограничения SDM как метода.
1.3. Область применения SDM и примеры.
1.4. Обзор методов, являющихся развитием SDM и смежных с SDM.
2. Qb.SDM: информация о программном комплексе.
2.2. Qb.SDM: описание входных параметров.
2.3. Qb.SDM: представление и интерпретация результатов.
2.3.1. Раздел “результаты моделирования”.
2.3.2. Раздел “метрики качества”.
2.3.3. Раздел “кривые откликов”.
2.3.4. Раздел “важность предикторов”.
2.4. Qb.SDM: техническое описание алгоритмов:
2.4.1. Предварительная подготовка наблюдений.
2.4.2. Предварительная подготовка предикторов.
2.4.3. Подготовка фоновых точек и точек псевдоотсутствия.
2.4.4. Учёт фактора мобильности вида (М-фактор).
2.4.5. Описание работы модели.
SDM - метод экологического моделирования, прогнозирующий географическое распространение видов. Альтернативные названия метода: ENM (ecological niche modelling), BEM (bioclimatic envelope modelling), HOM (habitat occupancy modelling), SIP (species invasions projections) [1].
Исходными данными для SDM являются:
- наблюдения - информация о присутствии вида (географические координаты);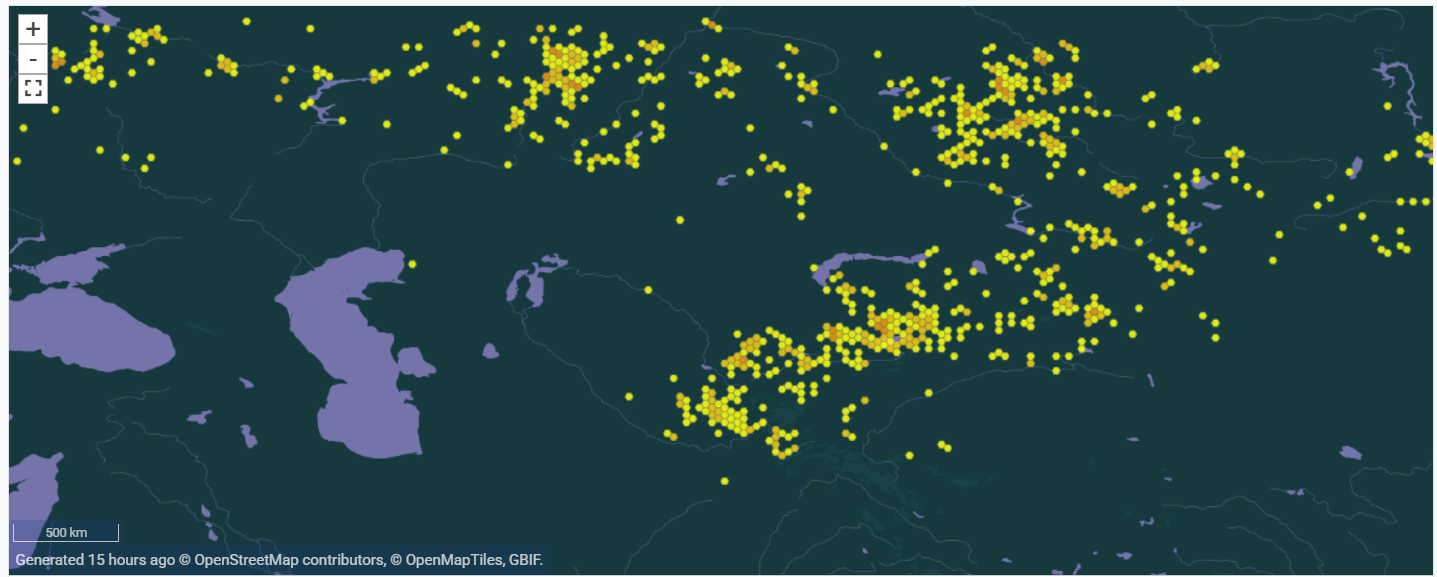
Под предикторами, ими биогеографическими переменными, понимают набор карт со значениями, характеризующими регион моделирования. Примеры: среднегодовая температура и амплитуда, сумма осадков и среднегодовая влажность, высота над уровнем моря и уклон рельефа, физический и химический состав почвы и т.д.
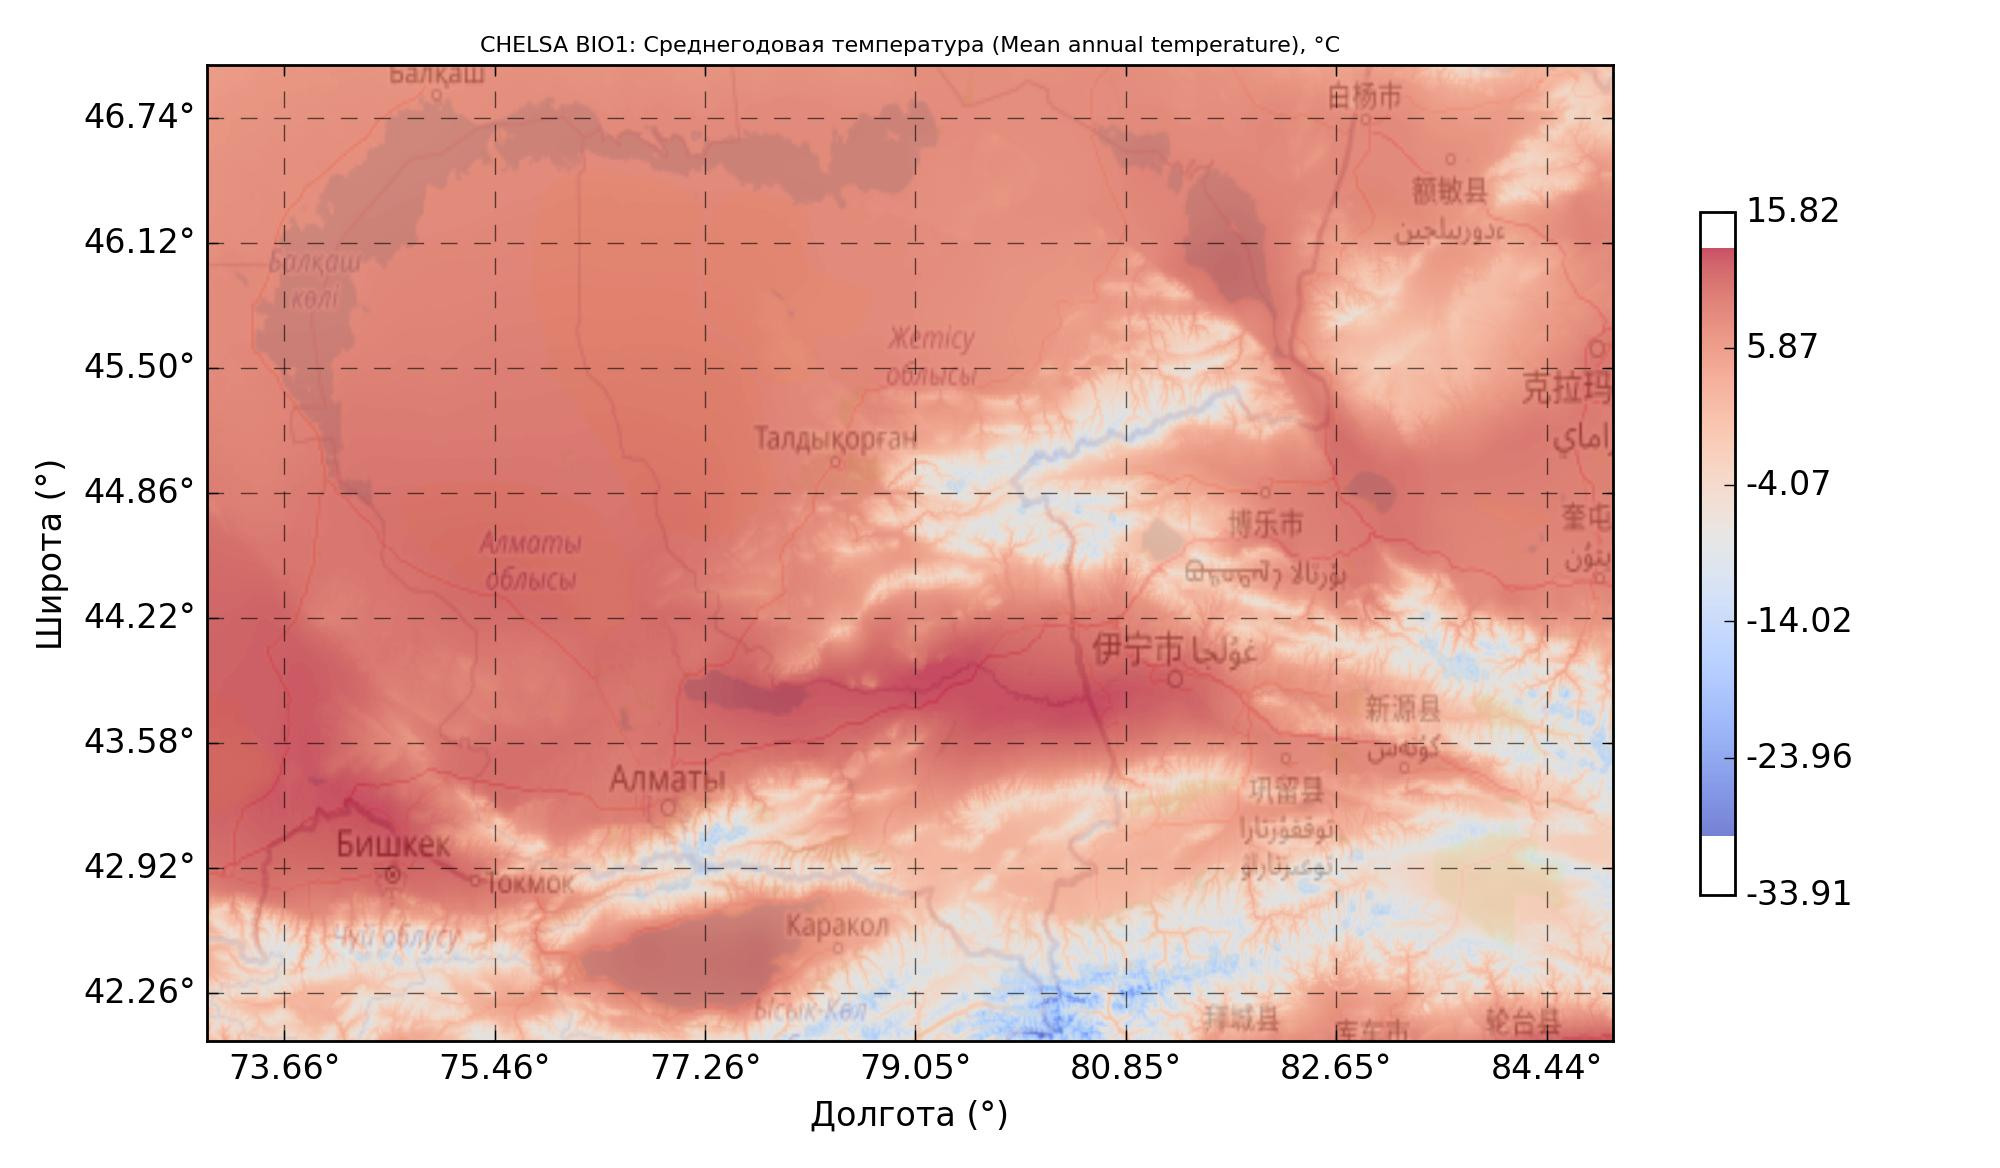
Эти данные подаются на вход алгоритма (один из методов машинного обучения: Random Forest, XGBoost, MaxEnt и др).
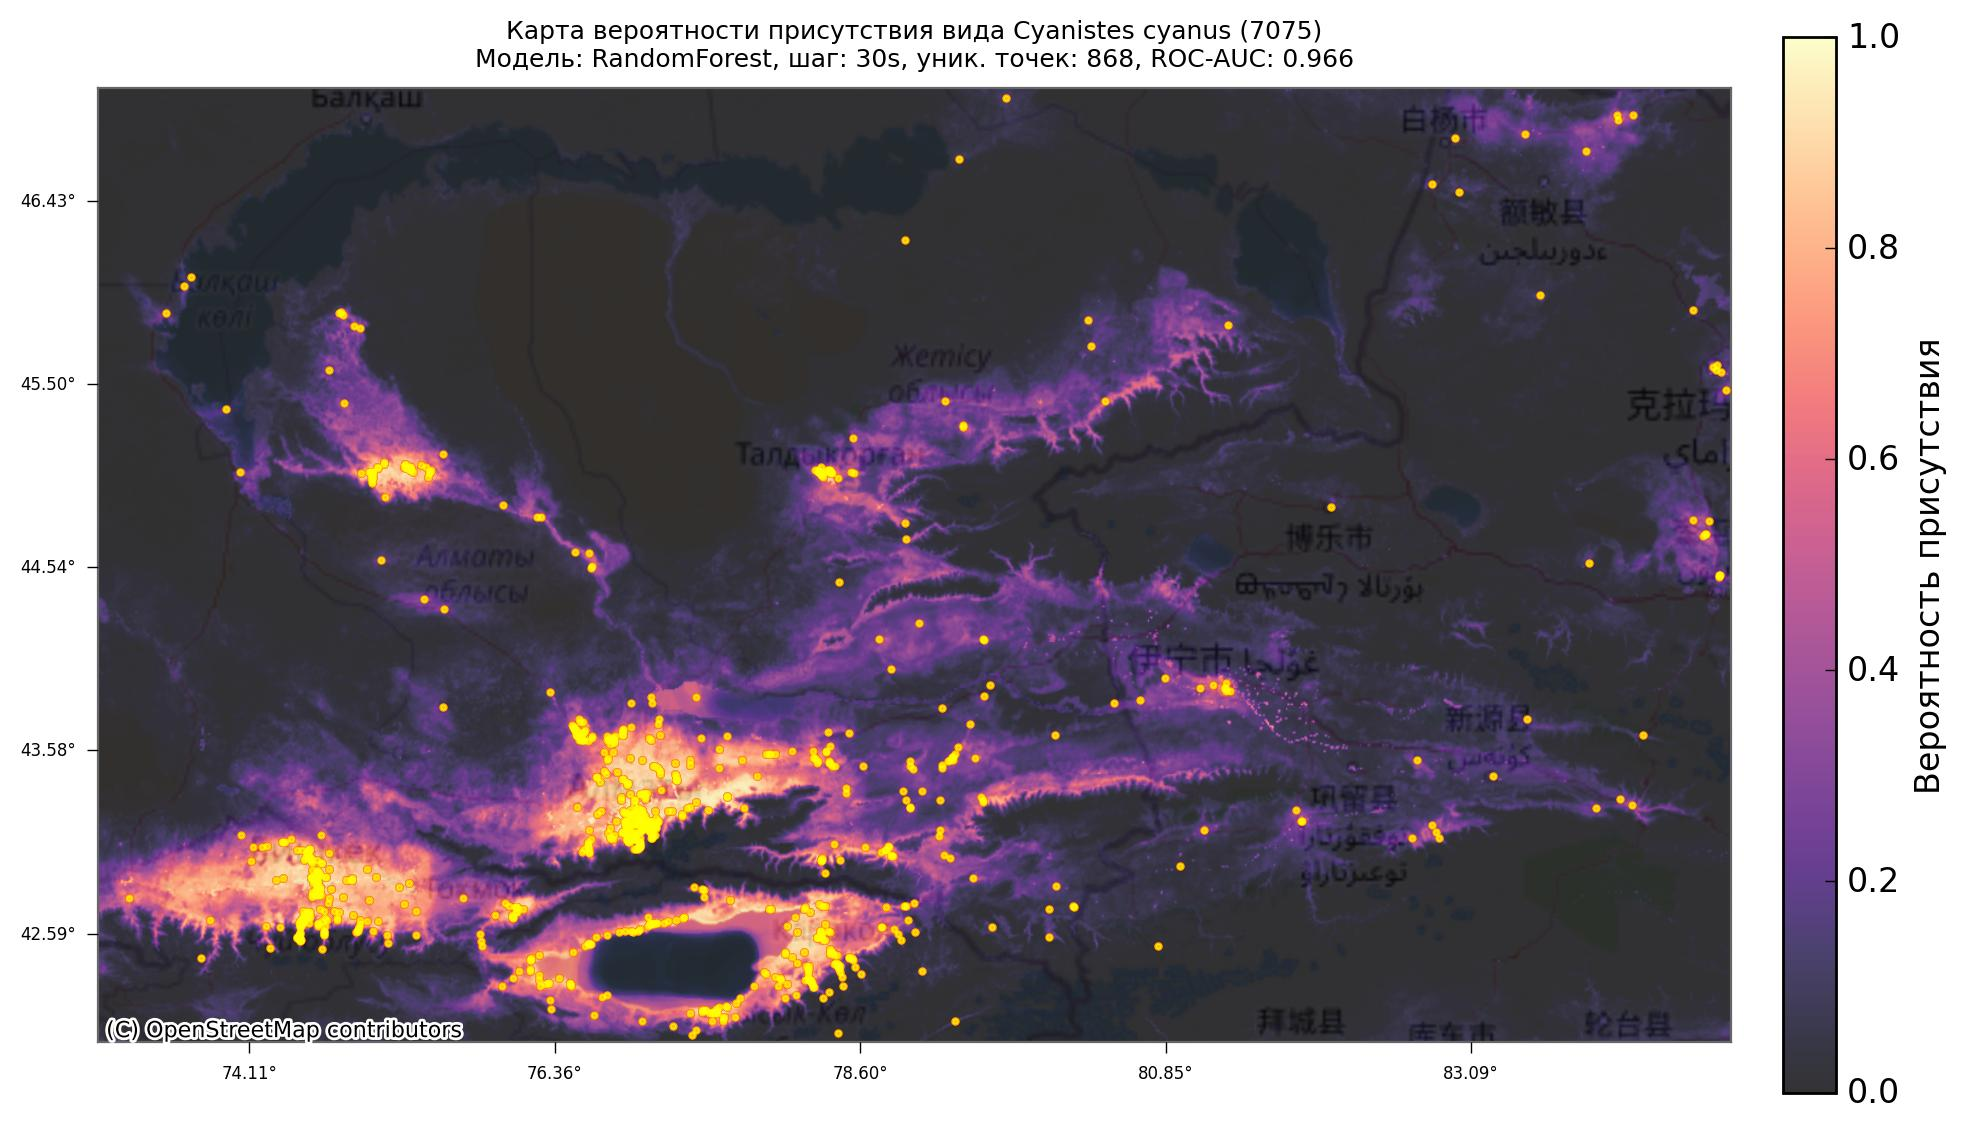
Алгоритм находит зависимость между наблюдениями и предикторами, т.е. условия, подходящие для вида. Результат работы алгоритма заявляется как вероятность присутствия вида в данной точке (с т.з. экологии правильнее говорить о подходящести местообитания в данной точке для вида). Результат работы модели представляет собой значение от 0 до 1, часто выражается в процентах от 0% до 100%.
Далее алгоритм применяется ко всем географическим точкам в заданном регионе - и вычисляются вероятности присутствия вида (подходящих местообитаний). Для наглядности результат проецируется на географическую карту:
Основная идея SDM - определение “комфортных условий” для вида. Под комфортными условиями подразумевается набор климатических и других параметров, в которых вид может долговременно существовать (местообитание).
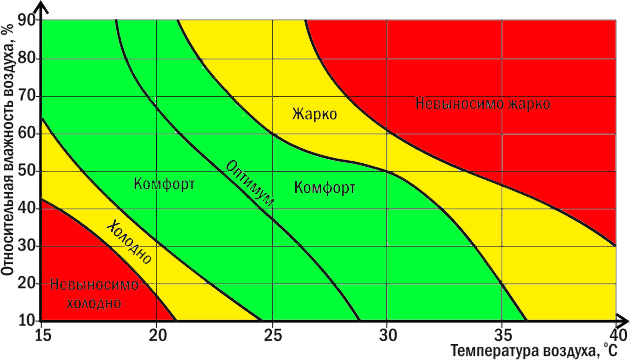
Экологическая ниша (по Дж.Э.Хатчинсону) — это функциональное место вида в экосистеме, охватывающее весь комплекс его требований к условиям обитания (местообитание: температура, влажность и т.д.) и роль в биоценозе (биотические факторы: пищевые связи, конкуренция и т.д.).
Базой для работы SDM является гипотеза консервативности экологической ниши. Это предположение, что разные особи вида существуют в одной экологической нише - и эта экологическая ниша не меняется за период, моделируемый SDM. Либо это изменение настолько мало в диапазоне моделирования, что им можно пренебречь.
Результатом работы SDM является поиск подходящего местообитания для вида. Часто говорят, что SDM моделирует экологическую нишу вида - однако, в строгом экологическом смысле это неверно, т.к. SDM обычно не моделирует биотические факторы. [1]
Механика работы SDM заключается в следующем:
1) Собранные наблюдения проецируются на карты слоёв-предикторов:
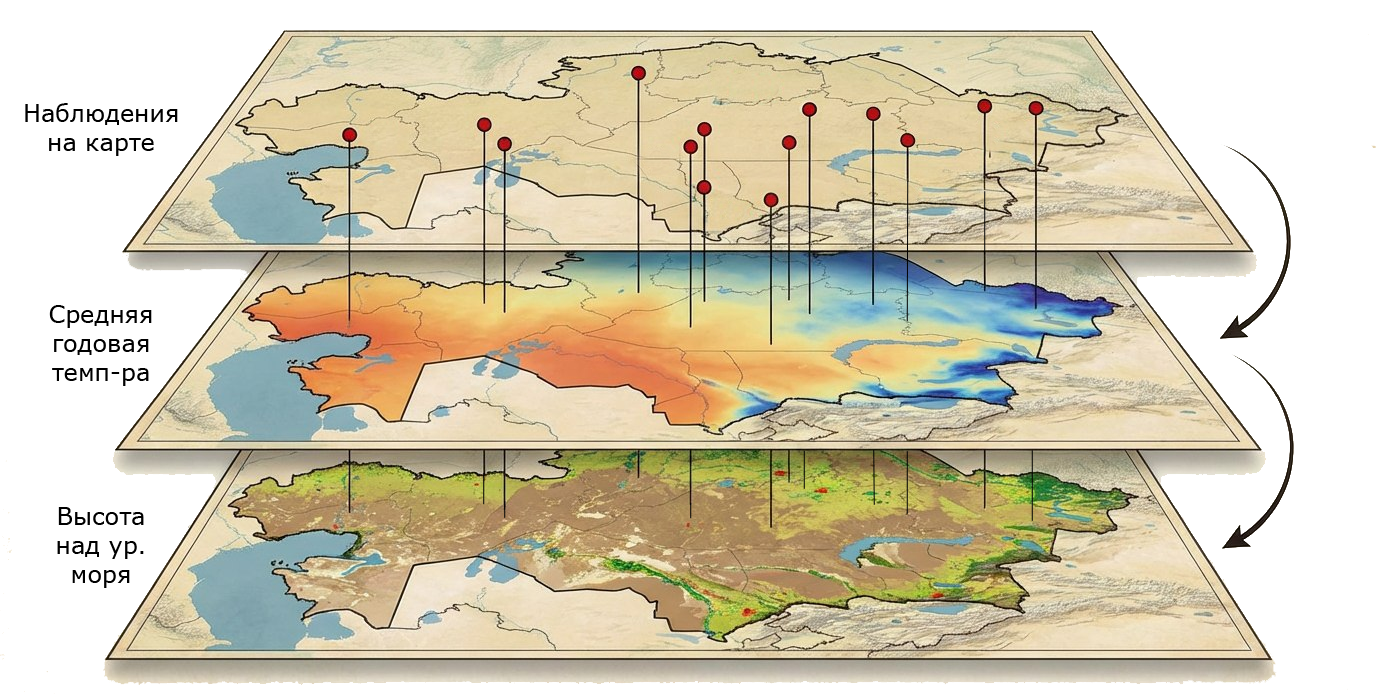
2) В результате проекции получается массив значений биоклиматических переменных в точках наблюдения вида:
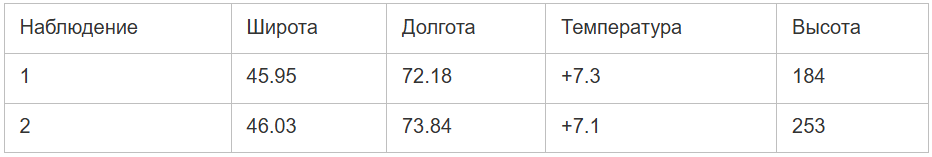
3) На основании этого массива вычисляются условия (набор переменных), в которых вид может существовать. Эти условия считаются экологической нишей в пространстве заданных предикторов.
Зафиксируем, что это не вся экологическая ниша, т.к. условия не учитывают биотические взаимодействия:
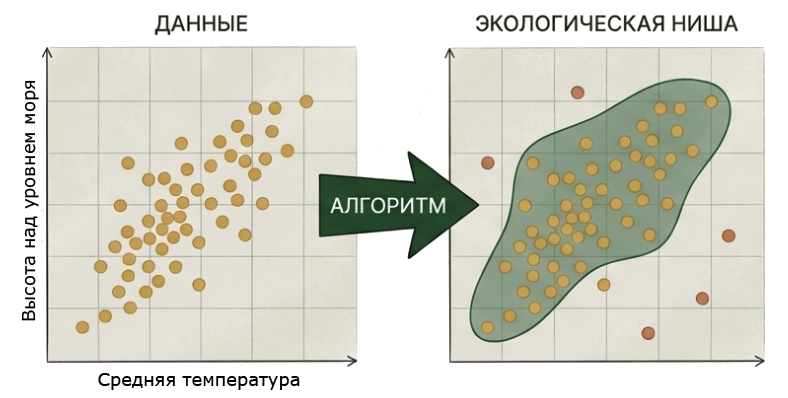
За пределами точек наблюдений формируются фоновые точки и точки псевдоотсутствия. Фоновые точки равномерно распределяются по доступной области в случайном порядке. Точки псевдоотсутствия набираются по алгоритму RSEB: на определённом расстоянии от точек встречи вида. Подробнее про метод RSEB см. в пункте 2.4.3 и [3].
4) Для точек присутствия целевая переменная полагается равной 1, для фоновых точек и точек псевдоотсутствия целевая переменная полагается равной 0.
5) Для данного набора данных запускается алгоритм машинного обучения. В процессе обучения решается задача регрессии, т.е. для любого набора биоклиматических переменных модель даёт предсказание в диапазоне от 0 до 1 - степень подходящести местообитания.
6) Для каждой точки карты определяется набор значений биоклиматических переменных. К ним применяется модель, дальше результат её работы проецируется на карту.
Результат работы SDM представляется в формате карты.
Варианты визуализации:
- значения вероятности присутствия;
- либо задаётся пороговое значение (например, 95%) - и на карте обозначаются все области со значением вероятности выше порогового. Часто для визуального выделения таких областей задаётся огибающий “буфер” размером в несколько километров (например, 1-5 км).
1.2. Ограничения SDM как метода.Важно понимать, что именно моделирует SDM: это подходящие местообитания.
Т.е. это области, в которых биоклиматические переменные подходят под условия существования вида (по мнению модели).
Традиционные SDM не учитывают следующие факторы:
- биотические факторы (конкуренция, пищевые отношения и т.д.); - исторические факторы (например, распространение вида в прошлом было ограничено ледниковым периодом); - географические факторы (например, вид не может преодолеть горную систему или водоём); - факторы, которые явно не загружены в модель (например, виду требуется определённая солёность почв, но такой предиктор для обучения не использовался); - сезонность и миграцию.Однако, есть множество вариантов развития SDM, добавляющих учёт этих факторов. Подробнее см. раздел 1.4. Часть этих факторов также моделируется в Qb.SDM
Таким образом, SDM может показывать области, где вида в настоящее время нет, но там есть подходящие для него условия (по мнению модели, с учётом использовавшихся предикторов). Либо вид там не наблюдался (нет наблюдателей) - и эти области стоит тщательнее изучить.
Возможна и обратная ситуация, когда вид присутствует в областях, не показанных моделью. Возможные причины:
- наблюдение вне пределов подходящих местообитаний, например, во время миграции, бегства от хищников и пр.; - модель недостаточно точная (например, в ней не учтены предикторы, влияющие на этот вид); - в данной области существует фактор, положительно влияющий на вид даже за пределами его комфортного местообитания (например, избыток добычи); - гипотеза консервативности экологической ниши не выполняется для данного вида в данных условиях (например, вы подаёте на вход модели наблюдения двух подвидов с разными местообитаниями/экологическими нишами. Модель фактически объединит эти ниши).Отдельно остановимся на биотических факторах. В экологии традиционно высокое значение уделяется взаимодействию видов друг с другом: конкуренции, пищевым отношениям и т.д. SDM обычно не учитывают такие факторы, но при этом демонстрируют высокую степень точности при моделировании на больших масштабах.
Этот вопрос подробно исследовался, и была выдвинута так называемая гипотеза элтоновского шума. Суть этой гипотезы в том, что на достаточно больших масштабах (десятки и сотни километров) для многих видов биотические факторы становятся случайным фактором, “шумом”, не оказывающим заметного влияния на распространение видов. Область применимости гипотезы в настоящее время обсуждается. Подробнее см. в поисковых системах по запросу “Eltonian Noise Hypothesis”.
1.3. Область применения SDM и примеры.Метод SDM широко применяется в биологии, экологии, природоохранной, охотоведческой деятельностях - и многих других. Примеры применения:
- поиск редких животных и растений, их местообитаний. SDM помогает узнать, где ещё может “скрываться” редкий вид, в каком местообитании его искать. С помощью SDM были обнаружены многие ранее неизвестные популяции; - изучение экологической ниши вида. С помощью SDM можно определять предпочтения вида статистическими методами: какой климат, рельеф, почва и т.д. предпочтительны для вида - без полевых исследований и экспедиций; - природоохранная деятельность. С помощью SDM можно определить, какие территории важны для многих видов, т.н. “горячие точки биоразнообразия”. Решить, какие из них требуют сохранения и защиты. С помощью SDM было обосновано создание многих КОТ, КБТ, ООПТ: ключевых орнитологических территорий, ключевых ботанических территорий, особо охраняемых природных территорий, национальных парков и заповедников; - прогнозировать будущее видов: SDM помогает прогнозировать изменение местообитаний в случае изменения климата и других условий. Какие местообитания могут быть утрачены, куда могут “переехать” обитающие там виды. На практике SDM строит не один прогноз, а сразу несколько сценариев для разных вариантов SSP; - изучать историю жизни. Некоторые климатические предикторы позволяют “отмотать время назад”. Например, CHELSA даёт набор биоклиматических переменных на 21 тысячу лет назад с шагом в 100 лет: набор TraCE21k [4].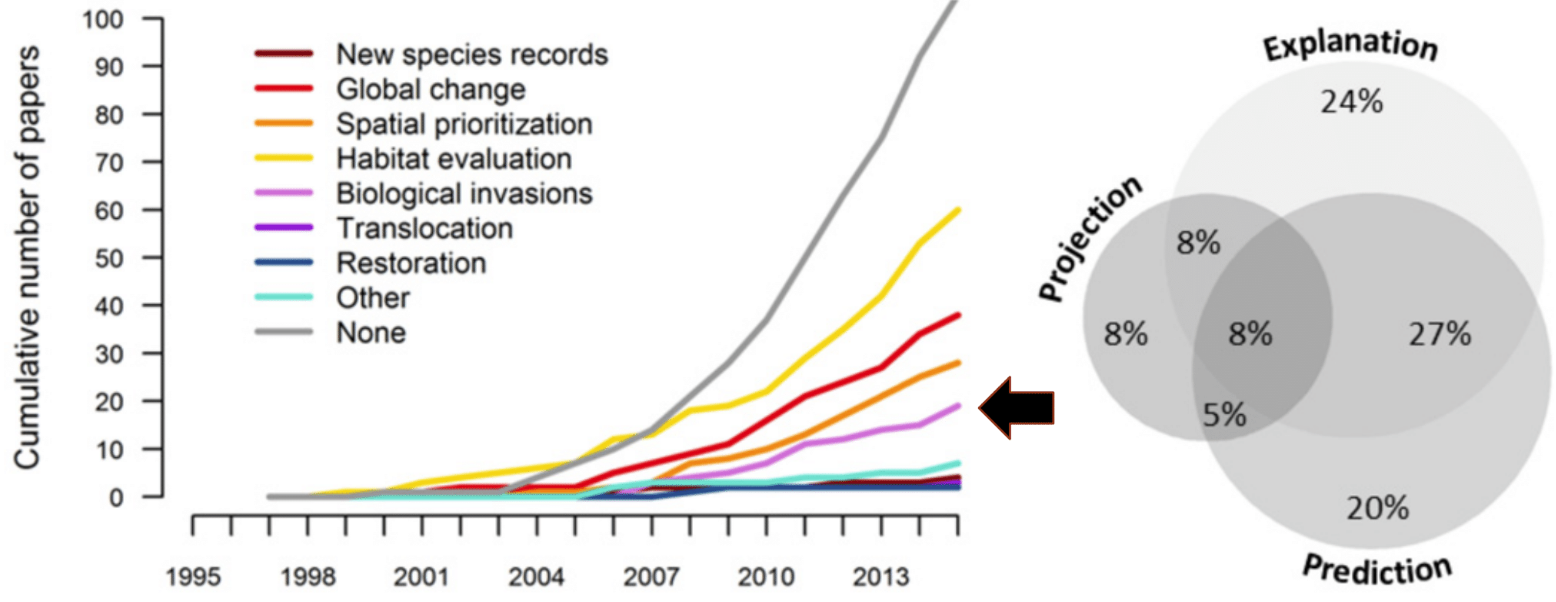
Существует целый пласт методов, развивающих идею SDM с помощью добавления дополнительной информации, либо смежных с SDM. Вот основные:
1. Методы, моделирующие взаимодействие видов, учитывающие биотические факторы:
Дальнейшее развитие:
Программный комплекс Qb.SDM реализован в браузере. Для запуска моделирования нет необходимости устанавливать дополнительное программное обеспечение, достаточно будет браузера: Chrome, Edge.
2.1. Qb.SDM: быстрый запуск.Откройте в браузере ссылку https://wingeds.world/sdm
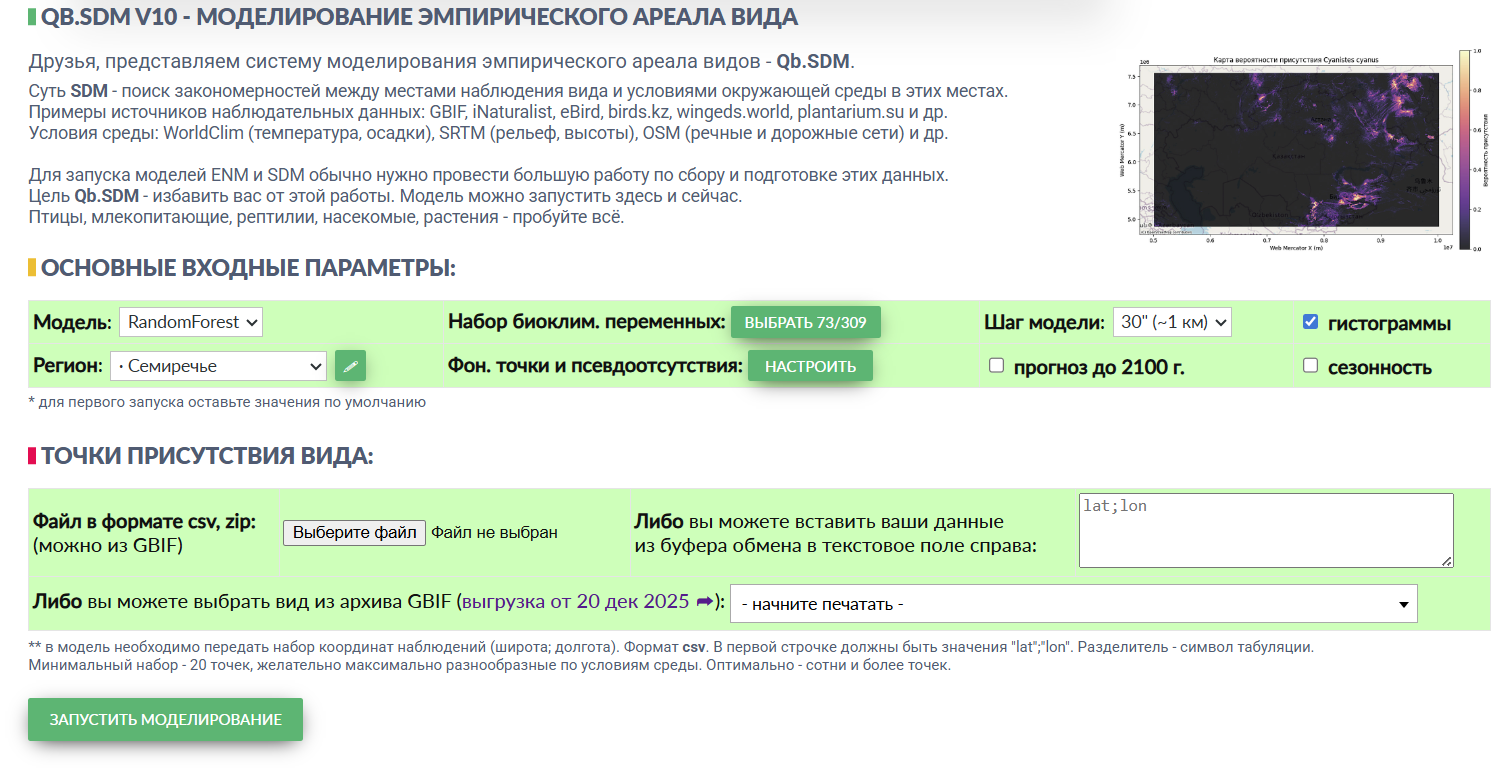
Qb.SDM интегрирована с глобальной базой данных по биоразнообразию GBIF. Это значит, что для многих видов животных и растений в Qb.SDM уже есть достаточно информации, чтобы запустить модель и построить карту присутствия вида.
Для быстрого запуска большинство настроек можно не трогать, достаточно выполнить два шага:
1. В поле “регион” выбрать интересующую область моделирования. Для начала рекомендуется попробовать небольшое регион, например, Семиречье или Кавказ - так вы быстрее увидите результат. 2. В самом нижнем поле нужно выбрать вид. Справа внизу в окне “начните печатать” введите название интересующего вида. Не для всех видов в базе есть русскоязычные названия, если не получилось найти вид - попробуйте название на латыни (проще всего его можно взять из странички вида в википедии).Для примера попробуйте ничего не менять, только выбрать вид “Белая лазоревка (князек)” - и нажмите кнопку “запустить моделирование”:
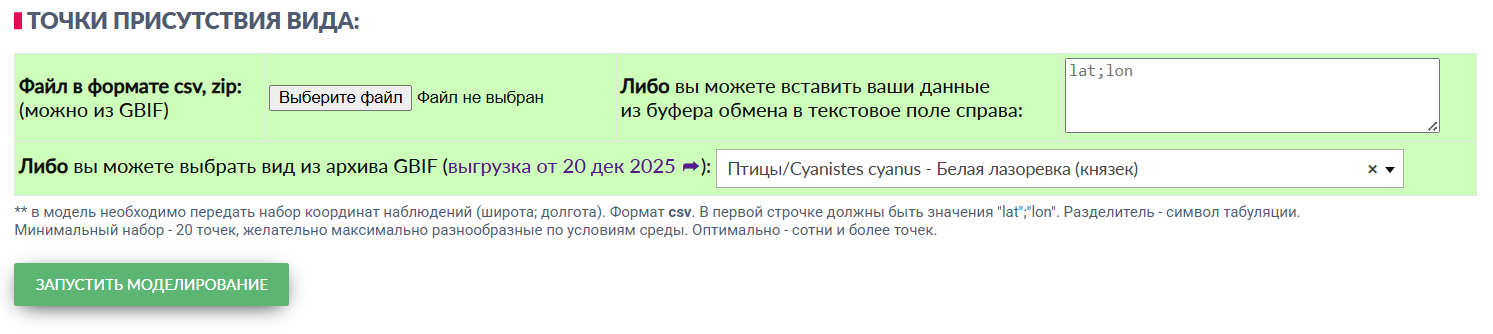
Через несколько минут вы получите результат работы модели в таком виде:
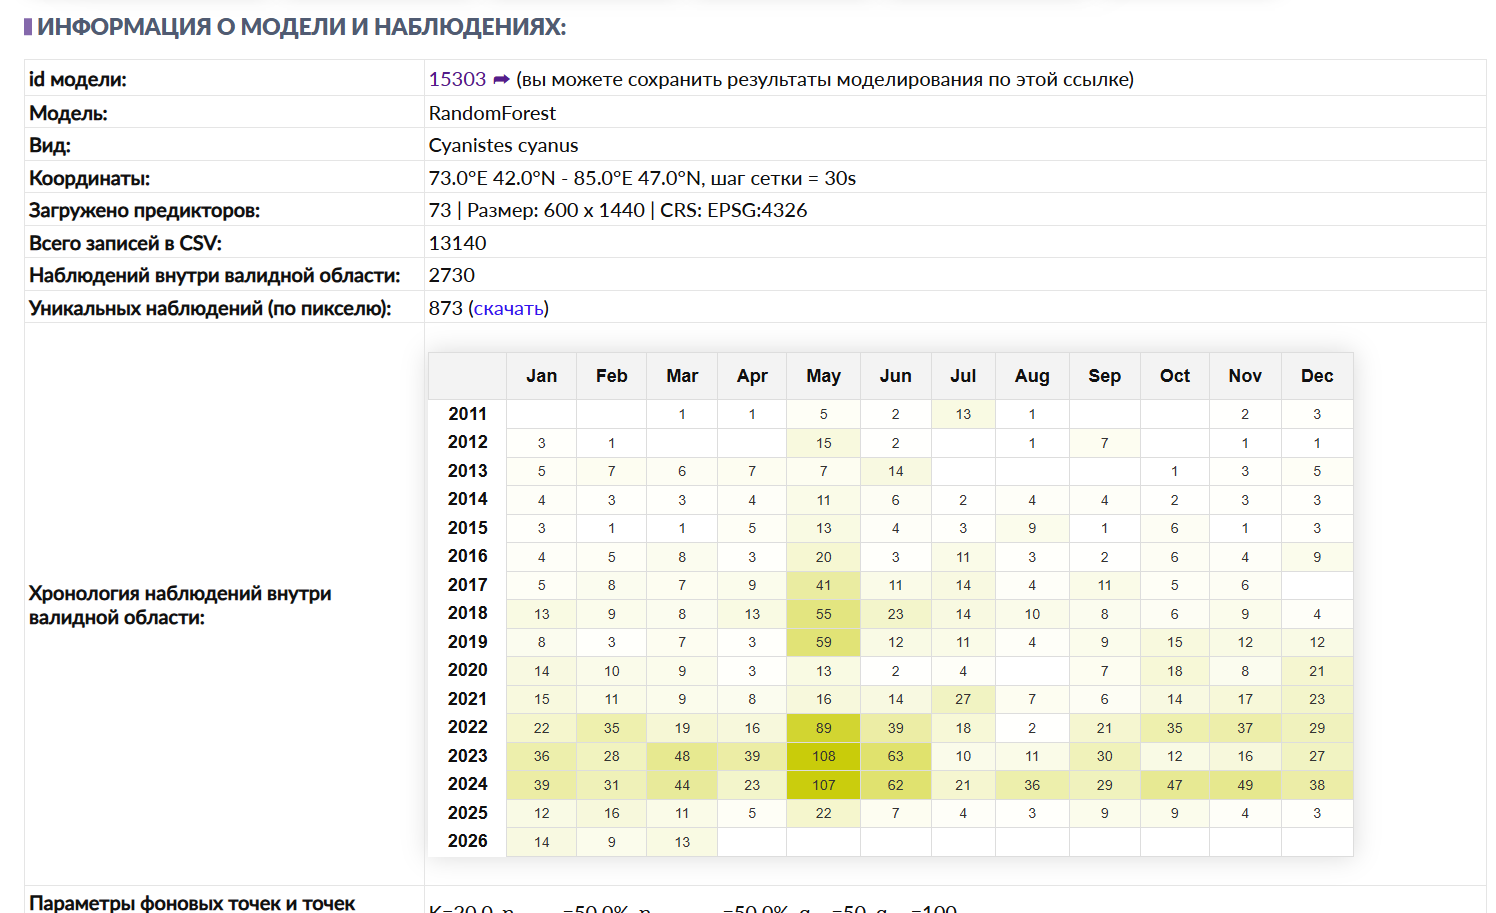
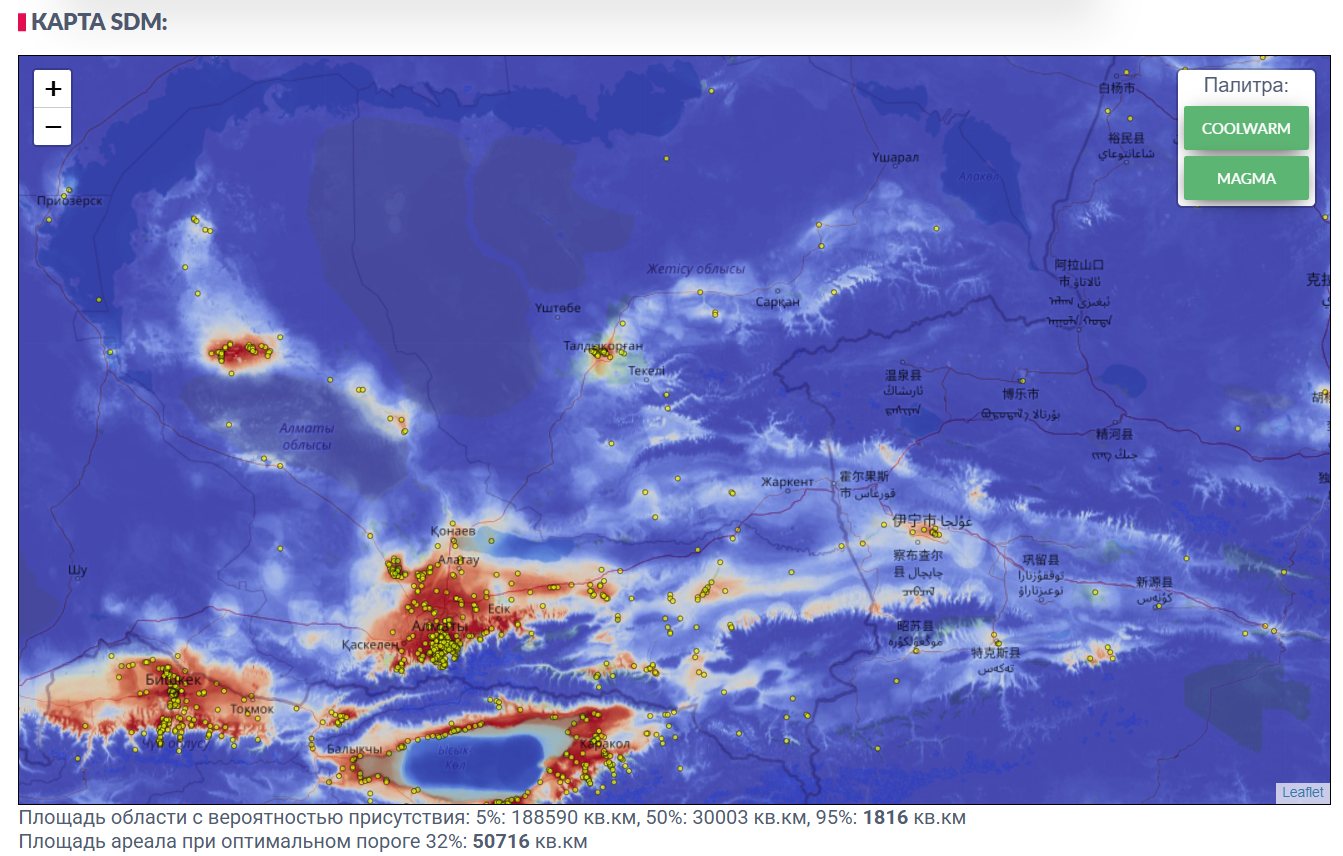
Пример: результат SDM для князька (Cyanistes cyanus), регион моделирования - Семиречье [M2]
Подробнее о представлении и интерпретации результатов - см. раздел 2.3.
Ниже речь пойдёт о более осмысленном указании входных параметров.
2.2. Qb.SDM: описание входных параметров.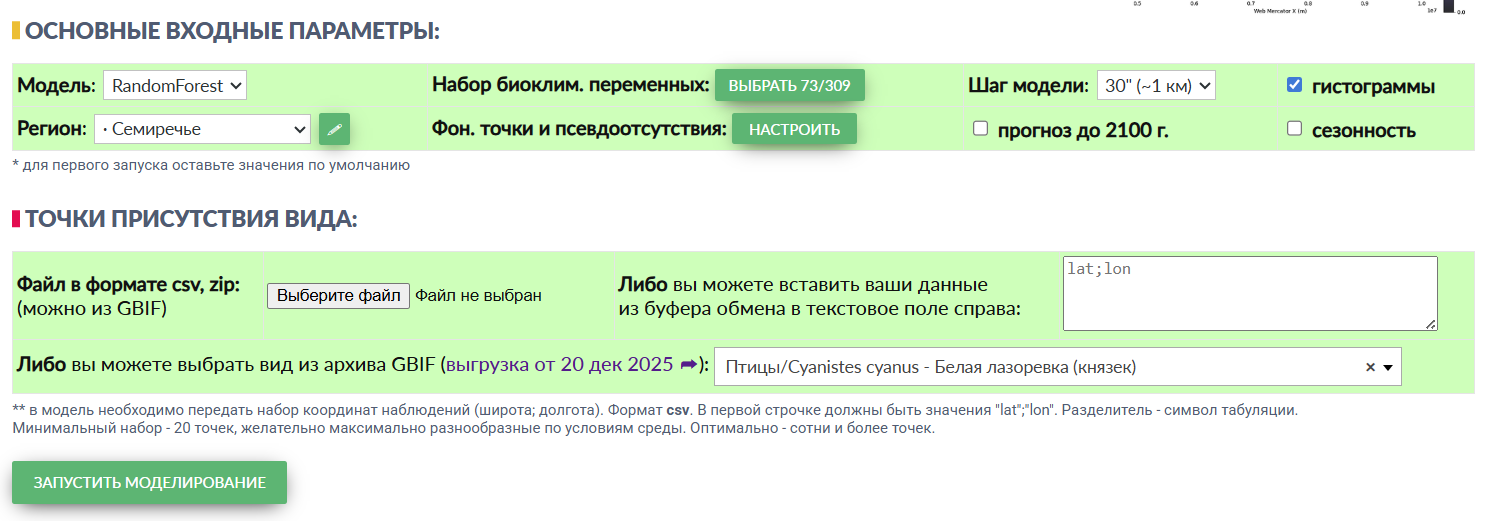
Основные входные параметры модели изображены выше. Если вы пользуетесь данными GBIF, достаточно указать регион и вид, дальше система сама подберёт оптимальные параметры для моделирования.
Для остальных случаев остановимся на параметрах подробнее.
2.2.1. “Модель”. Здесь доступны три варианта:
- RandomForest, “ансамбль решающих деревьев” - модель по умолчанию. Даёт наиболее “мягкое” представление результата и обычно лучшую точность; - XGBoost, “градиентный бустинг” - вторая модель по умолчанию. Часто показывает точность лучше, чем RandomForest, но более резко определяет границы распространения видов, что может не соответствовать реальным встречам; - MaxEnt, “максимизация энтропии” - альтернативная модель. Если модели RandomForest и XGBoost лучше описывают реализованную экологическую нишу вида (с поправкой на эффект наблюдателя), то MaxEnt лучше описывает фундаментальную нишу (с той же поправкой). Для модели MaxEnt в Qb.SDM недоступен набор предикторов CHELSA, а также не реализовано моделирование сценариев будущего.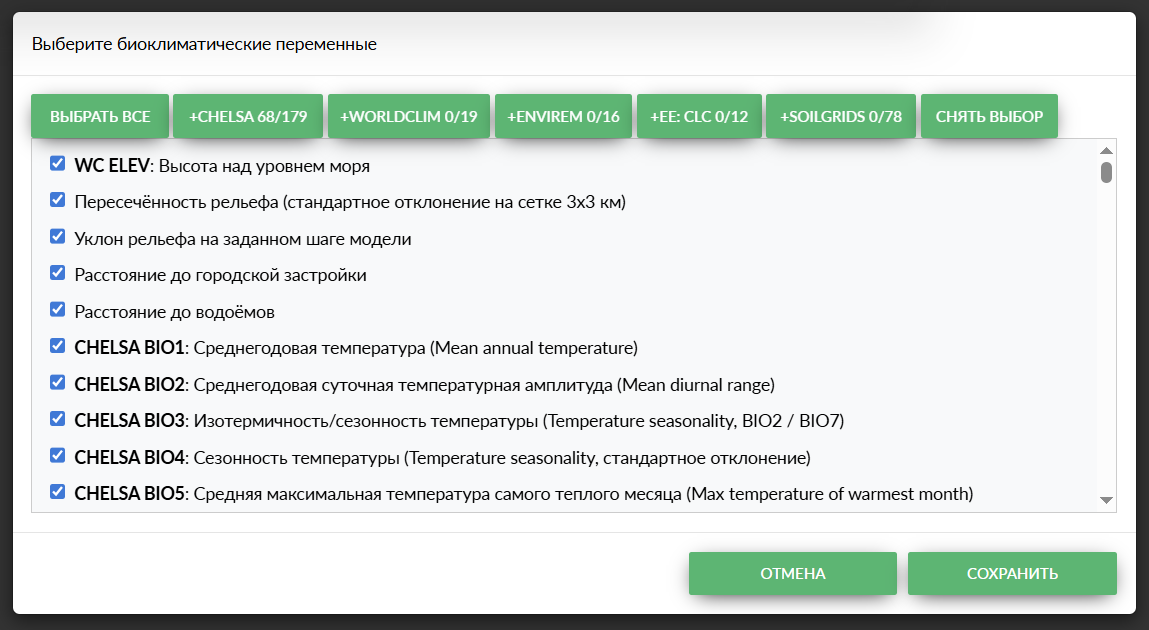
2.2.2. “Набор биоклиматических переменных”.
Доступны следующие наборы переменных:
- CHELSA [2] - наиболее актуальный и полный набор биоклиматически переменных, рекомендуемый в настоящее время для SDM; - WorldClim [5] - один из первых базовых наборов биоклиматических переменных, в настоящее время почти повсеместно заменён на CHELSA. Использование CHELSA и WorldClim одновременно не имеет смысла, предпочтительным вариантом является CHELSA; - ENVIREM [6] - набор комплексных биоклиматических переменных, дополняющих WorldClim. В настоящее время также повсеместно заменяется на CHELSA; - EarthEnv LandCover [7] - набор предикторов покрытия земной поверхности: растительность, водоёмы, городская застройка и т.д. Рекомендуется к использованию для большинства видов. Пример, когда нужно использовать EE CLC с осторожностью: когда нужно явно разделить подходящесть местообитания в городах и human bias factor; - SoilGrids [8] - набор предикторов о физическом и химическом составе почв. Наиболее важен для наземных животных и растений.Модель MaxEnt чувствительна к коллинераности (созависимости) предикторов, поэтому для неё использование многих предикторов ограничено, и рекомендуется добавлять по один-два за каждый прогон.
Модели RandomForest и XGBoost не чувствительны к коллинеарности, поэтому для них можно использовать практически все доступные предикторы.
Важное ограничение: число уникальных наблюдений должно быть заметно больше, чем число используемых предикторов. Например, если у вас всего 100 наблюдений, рекомендуется ограничиться 20-30 слоями предикторов.
2.2.3. “Шаг модели”, варианты: 30” (угловых секунд, примерно 1х1 км), 1’ (угловая минута, примерно 2х2 км), 5’ (угловых минут, примерно 10х10 км).
Чем более крупный шаг, тем быстрее будет выполняться модель - и тем грубее будет результат. Для точности оптимально использовать шаг 30”, однако, при моделировании больших регионов (например, весь Казахстан или Россия) разрешение модели ограничено одной угловой минутой из-за соображений производительности.
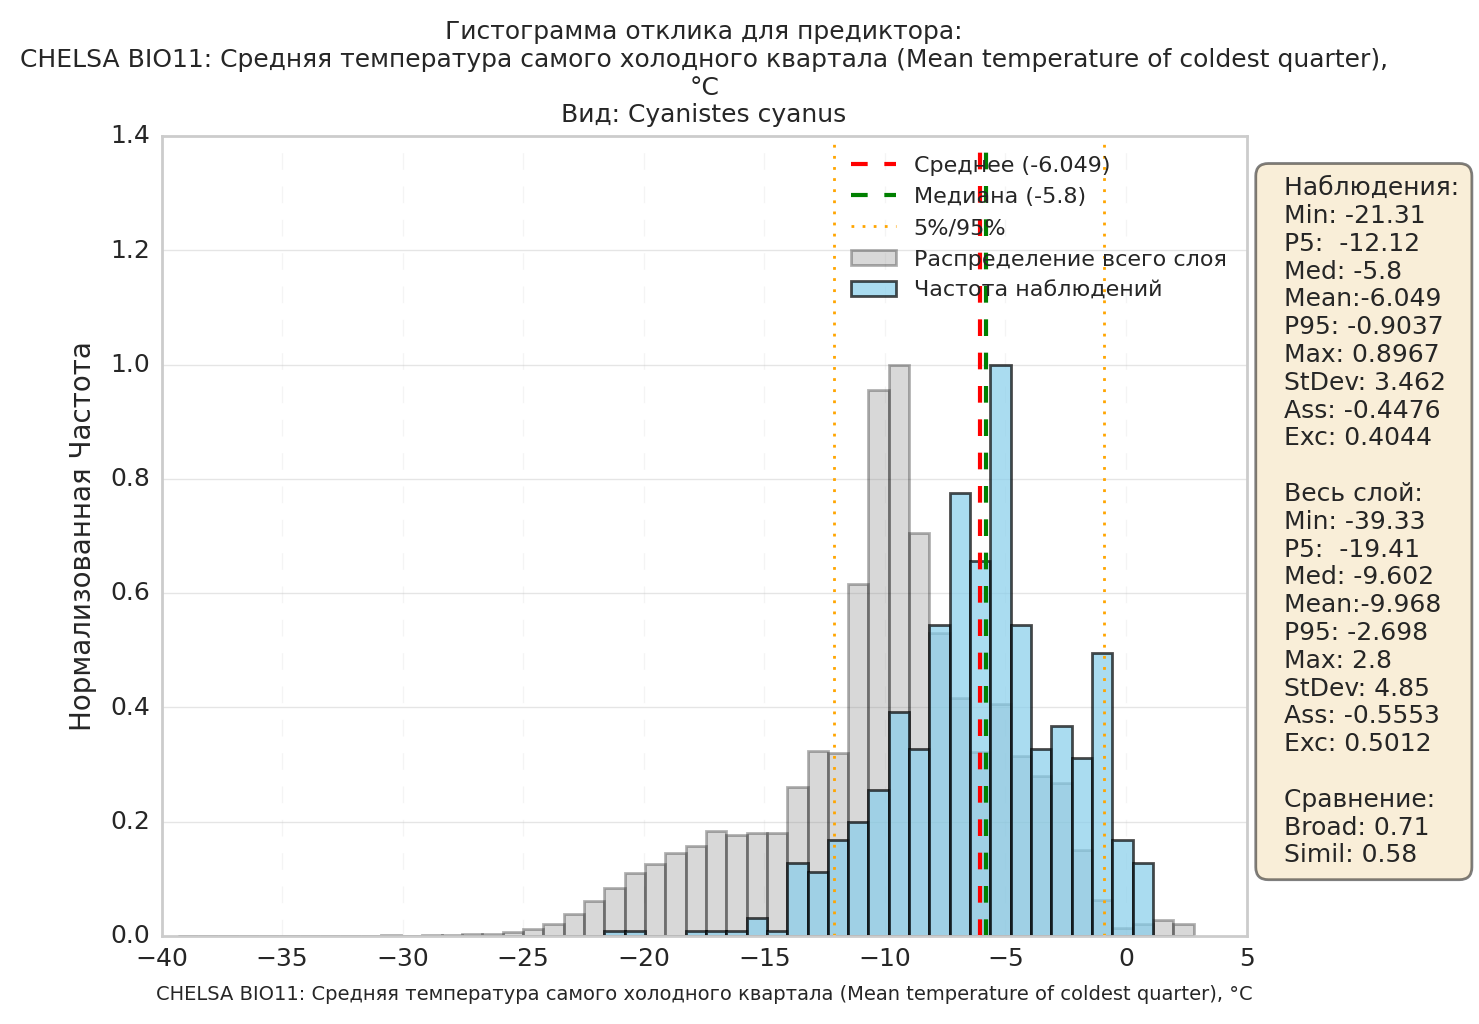
2.2.4. “Гистограммы”. Если отмечен этот пункт, система построит гистограмму для всех выбранных слоёв-предикторов. Гистограммы могут дать дополнительную информацию об экологии вида, о его предпочтительных условиях, а также об условиях, доступных в этом регионе.
Из примера видно, что князёк предпочитает более тёплые условия, чем доступно в среднем по региону моделирования. Значит, этот фактор будет лимитировать его распространение.
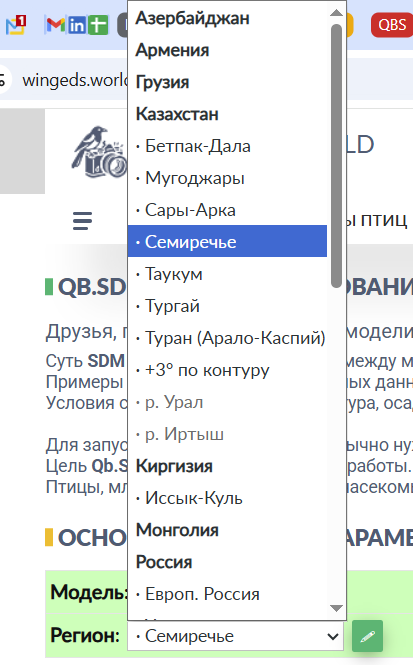
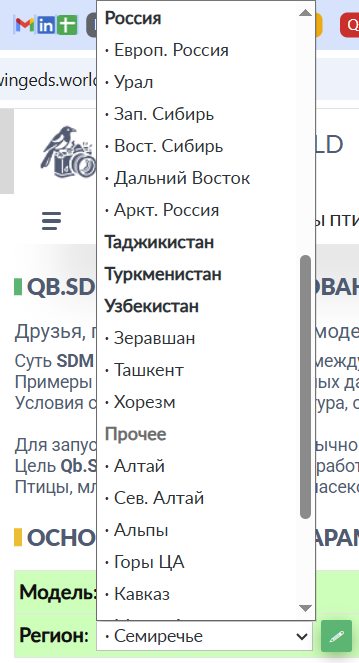
2.2.5. “Регион моделирования”. Рекомендуется использовать один из стандартных регионов, выбор достаточно большой.
Если вы не нашли подходящий регион в списке, можно указать свой регион, кликнув на карандашик справа от выпадающего списка:
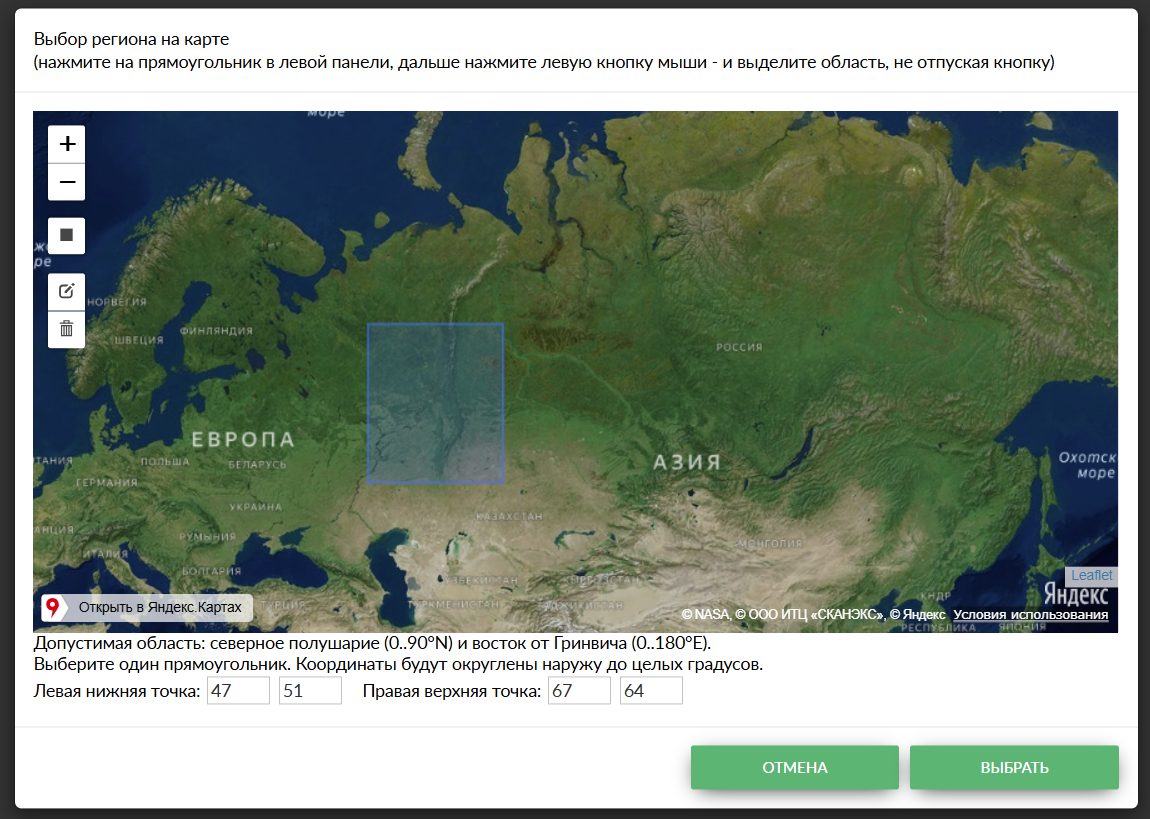
Далее можно нажать на серый квадрат слева - и указать мышкой нужный регион, либо ввести координаты (широту и долготу левой нижней и правой верхней точки) вручную.
Для нестандартных регионов область моделирования ограничена квадратом 20х20 градусов. Также для нестандартных регионов не осуществляется моделирование сценариев будущего.
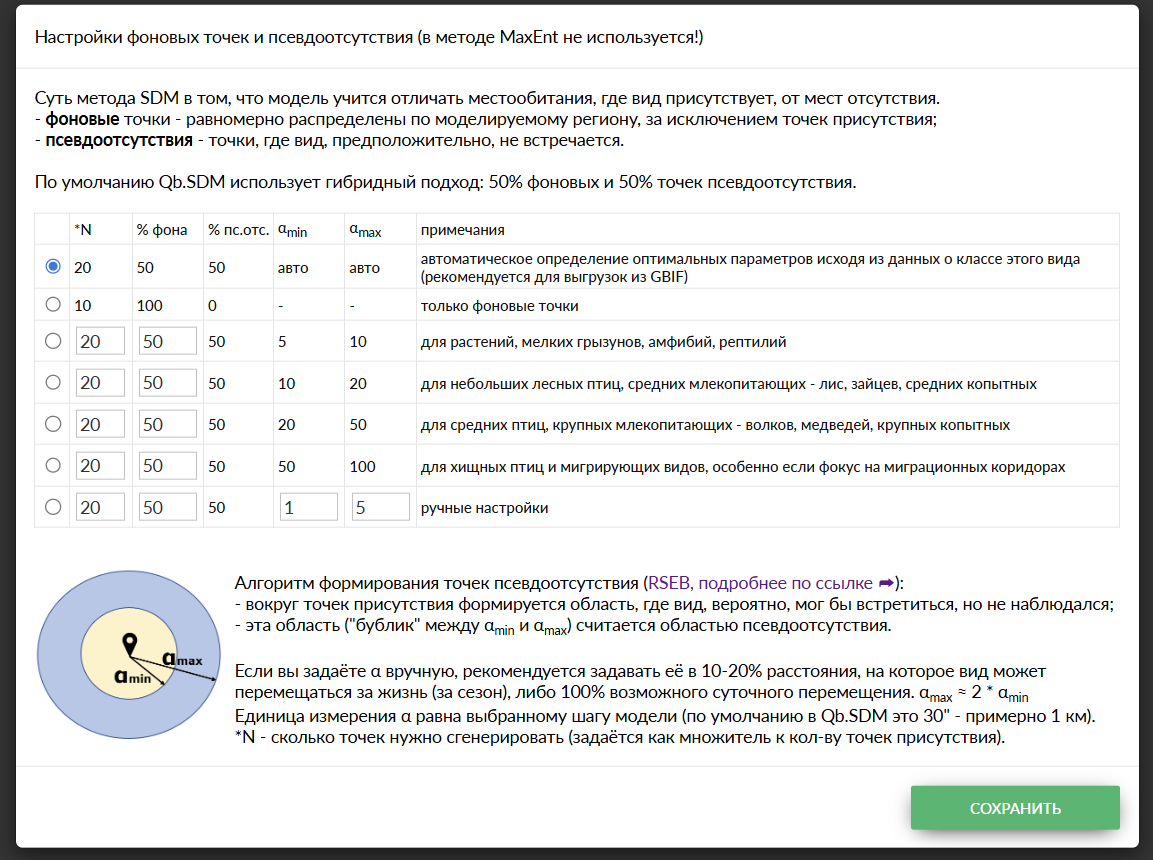
2.2.6. “Фон. и точки псевдоотсутствия”. Для работы алгоритмов машинного обучения нужно два вида точек. Первые - где вид присутствует - и это наблюдательные данные, ваши или из GBIF. Вторые - точки, где вид отсутствует. Дальше алгоритм учится предсказывать, насколько вероятна встреча вида в любой точке.
Обычно в наблюдательных данных есть только информация о присутствии вида - и нет данных, где вида нет. Но есть несколько алгоритмов, позволяющих сгенерировать такие точки статистическими методами.
Эти алгоритмы принимают на вход ряд параметров, которые можно определить, зная биологию вида. Подробнее о них рассказывается в разделе 2.4.3.
В систему Qb.SDM встроен алгоритм, который подбирает эти параметры исходя из табличных значений для группы видов. Для первого запуска вы можете положиться на этот алгоритм (первый пункт в списке “авто”), либо выбрать один из типовых наборов параметров. Также возможно полностью ручное управление этими параметрами. В пункте 2.4.3 описаны некоторые эвристики на этот счёт.
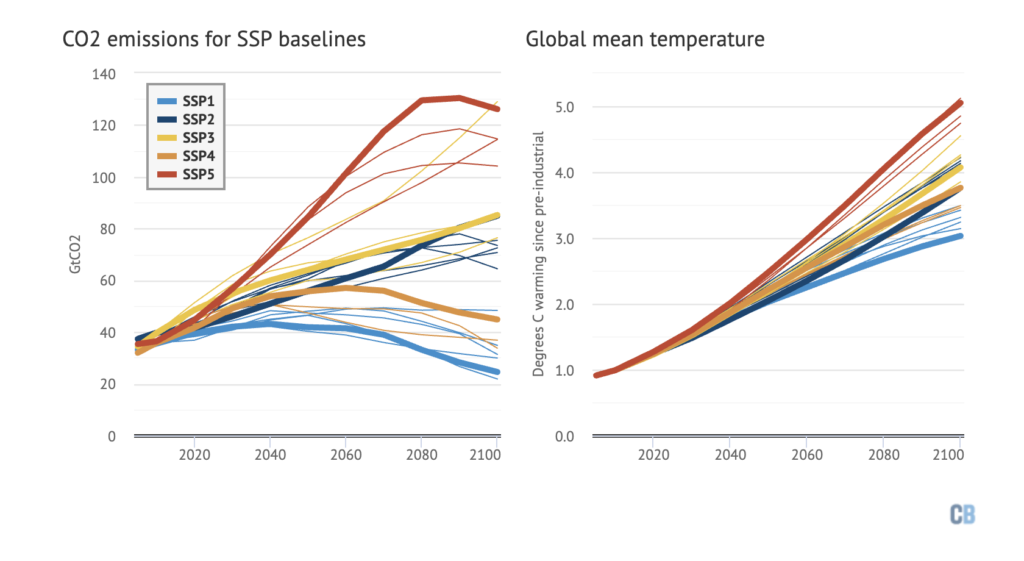
2.2.7. “Прогноз до 2100 г”. Климатологи разработали ряд сценариев по изменению климата Земли до 2100 года, так называемые SSP - “общие социоэкономические сценарии” [9]. Они моделируют “поведение” человечества в глобальном масштабе, и как следствие - изменение ключевых климатических переменных: средней температуры, количества осадков и т.д.
В контексте SDM сценарии SSP интересны тем, что поставщики основных биоклиматических переменных (CHELSA, WorldClim и др.) подготовили наборы предикторов, моделирующих разные сценарии в будущем [10].
В систему Qb.SDM заложена модель будущего от CHELSA в трёх сценариях: SSP1-2.6 (оптимистичный), SSP3-7.0 и SSP5-8.5 (пессимистичный). Отметив этот пункт, вы получите прогнозы изменения присутствия вида в этих трёх сценариях для трёх периодов: 2011-2040, 2041-2070, 2071-2100.
Какой из сценариев окажется ближе всего к реальности, заранее достоверно предсказать нельзя — это зависит от будущей климатической политики и социально-экономических факторов. При отсутствии дополнительной информации по конкретному региону или виду рекомендуется рассматривать все три сценария как равновероятные и сравнивать результаты между ними, а не полагаться на какой-то один.
Отдельно стоит иметь в виду: у сценария SSP3 есть не только уровень выбросов (7.0 Вт/м²), но и социально-политический сюжет — «Regional Rivalry», фрагментация мира, рост национализма, ослабление международного сотрудничества. Ряд наблюдателей отмечает, что именно этот сценарий стал выглядеть более правдоподобным в 2020-е годы на фоне роста геополитической напряжённости и деглобализации — независимо от того, совпадает ли фактический темп роста выбросов с расчётным для SSP3-7.0.
2.2.8. “Сезонность”. Отметив этот пункт, дополнительно к базовой модели вы получите набор из 12 моделей для каждого месяца. Такие модели могут представлять интерес, например, при изучении мигрирующих и кочующих видов.
Моделировать сезонность имеет смысл, если у вас есть не менее нескольких сотен наблюдений.
2.2.9. “Точки присутствия вида”. Система допускает три способа ввести наблюдательные данные:
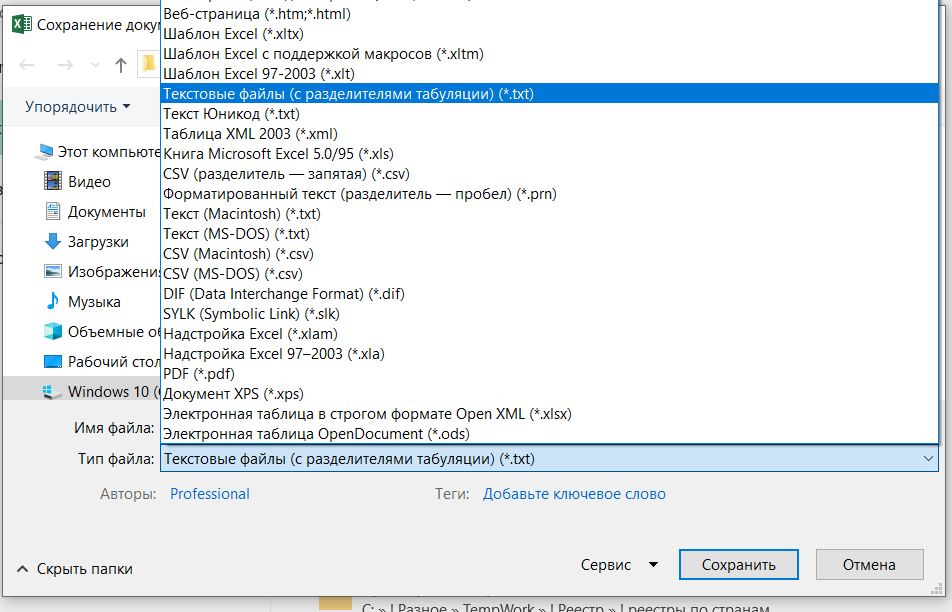
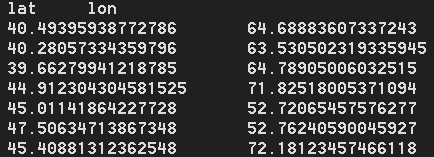
2.2.9.1. Загрузить файл в формате csv. В файле должны быть, как минимум, два поля: “lat” и “lon” - широта и долгота наблюдений в виде координат с точкой. Десятичный разделитель - точка. Разделитель ячеек - символ табуляции.
Важно: если вы сохраняете данные из Excel, нужно выбрать этот пункт:
Пример корректного файла:
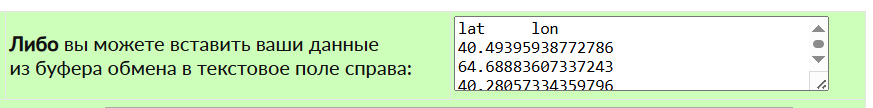
2.2.9.2. Второй вариант: вставить данные в аналогичном формате в поле “вставьте данные из буфера обмена”.
Результат будет выглядеть примерно так:
2.2.9.3. Третий вариант: выбрать имеющиеся данные их архива GBIF. Введите название интересующего вида в поле “начните печатать”. Не для всех видов в базе есть русскоязычные названия, если не получилось найти вид - попробуйте название на латыни (проще всего его можно взять из странички вида в википедии).
Результат будет выглядеть примерно так:

2.2.10. “М-фактор (доступность местообитания)”.
Помимо абиотической пригодности местообитания (климат, почва, рельеф — то, что непосредственно оценивает модель машинного обучения), Qb.SDM может дополнительно учитывать, насколько это местообитание физически достижимо для вида, исходя из известных точек наблюдений. Это отдельный множитель от 0 до 1, на который домножается итоговая карта пригодности: итоговая карта = абиотическая пригодность × М-фактор.
М-фактор приближённо рассчитывает «стоимость пути» от ближайшей точки наблюдения до каждой точки карты с учётом:
- дистанции расселения вида (км) — задаётся отдельно для текущего периода и для трёх периодов прогноза будущего (2011-2040, 2041-2070, 2071-2100), как правило увеличиваясь со временем;
- рельефа — крутые склоны увеличивают «стоимость» перемещения;
- высотных барьеров — вид не может преодолеть перевал или впадину, значительно отличающиеся по высоте от точек, где он наблюдался (с запасом на потепление климата);
- водных преград — для большинства видов открытая вода является барьером; для птиц этот барьер игнорируется, а для околоводных классов (например, амфибий) вода, наоборот, становится «коридором» расселения;
- предвзятости наблюдений (опционально) — учитывается дополнительный штраф за районы с низкой активностью наблюдателей, чтобы не путать «вида там нет» с «там никто не искал».
Значения по умолчанию подбираются автоматически по классу/царству вида (аналогично параметрам фоновых точек, см. п. 2.2.6 и 2.4.3), но могут быть заданы вручную. Есть возможность настроить или полностью отключить М-фактор полностью — тогда карта показывает только абиотическую пригодность местообитания без поправки на доступность. Техническое описание алгоритма — см. п. 2.4.4.
2.3. Qb.SDM: представление и интерпретация результатов. 2.3.1. Раздел “результаты моделирования”.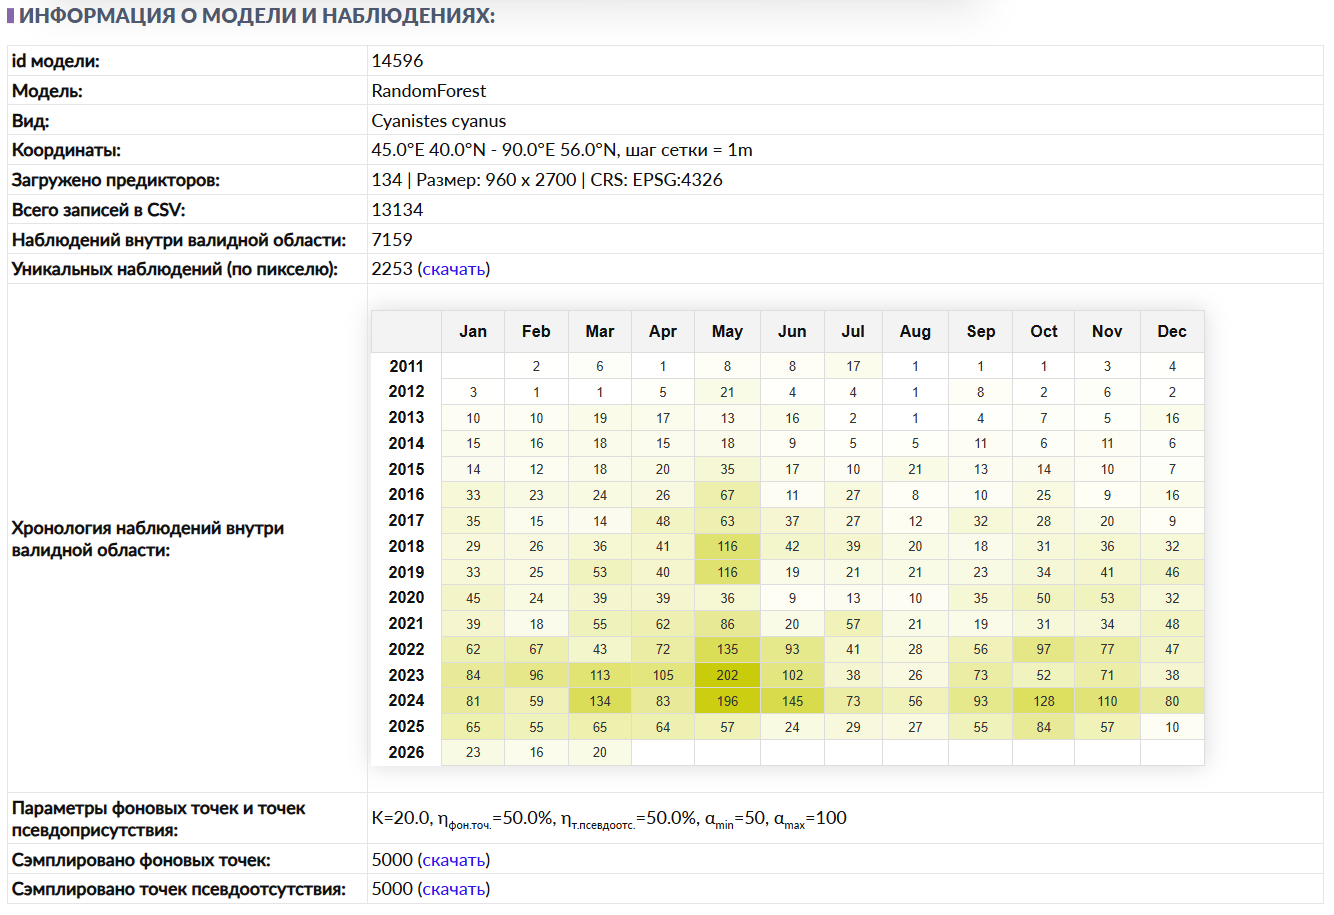
В разделе “результаты моделирования” представлена информация о поступивших входных данных, небольшая сводка по наблюдениям, а также метрика - оценки качества работы модели.
2.3.1.1. В строчке “id модели” приведена ссылка на текущую модель. Ссылку можно скопировать и сохранить, чтобы в будущем вернутся к этому расчёту. Пример ссылки: https:/wingeds.world/sdm/14047
2.3.1.2. В строчке “модель” указана модель, выполнявшая расчёт. Варианты:
- RandomForest; - XGBoost; - MaxEnt.2.3.1.3. “Вид” - биологический вид, для которого выполнялось моделирование. Это поле не влияет на расчёты непосредственно. Информация о виде берётся из загруженного файла csv из поля species (либо из данных GBIF, если исходные данные были выбраны через архив GBIF).
2.3.1.4. “Координаты” - географические координаты и размер шага сетки области моделирования.
2.3.1.5. “Загружено предикторов”. Первая цифра (24) - сколько предикторов было выбрано в этом сеансе моделирования. Далее указан размер предикторов в точках растра (600х1440) и географическая проекция растров.
2.3.1.6. “Всего записей в csv” - общее количество наблюдений в архиве. Обратите внимание, что не все наблюдения могут попадать в заданную область моделирования.
2.3.1.7. “Присутствий внутри валидной области” - общее число наблюдений из архива, попавших в заданную область моделирования.
2.3.1.8. “Уникальных присутствий по пикселю”. Логика работы SDM заключается в том, чтобы взять значения биогеографических переменных в точках присутствия вида - и на основании этой информации определить подходящие местообитания.
Однако, слои-предикторы идут с ограниченным пространственным разрешением (например, точка размером 30х30 угловых секунд) - и для каждой точки предиктора нет смысла вычислять значения несколько раз.
Поэтому общее число наблюдений внутри валидной области делится по точкам предикторов - и для каждой точки остаётся только одно наблюдение.
2.3.1.9. “Хронология наблюдений” - помесячное число наблюдений внутри заданной области моделирования.
2.3.1.10. Подробнее о фоновых точках и точках псевдоотсутствия см. раздел 2.4.3.
В данном блоке приведена следующая информация:
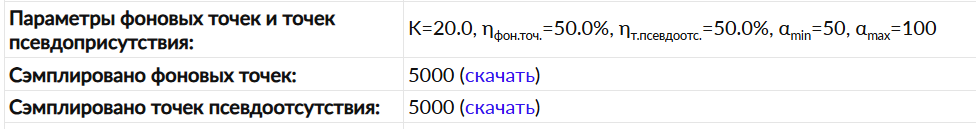
K=20 - во сколько раз нужно сгенерировать больше ФТ+ТП, по сравнению с числом уникальных наблюдений.
nфон.точ.=50% и nт.псевоотс.=50% - доля фоновых точек и точек псевдоотсутствия соответственно. Сумма равна 100%.
Например, если уникальных наблюдений было 25, K=20, n=50%, то будет сгенерировано 25 х 20 = 500 точек ФТ+ТП (250 ФТ и 250 ТП).
αmin=50 и αmax=100 - расстояние в единицах точки растра, в пределах которого будут генерироваться точки псевдоотсутствия.
Суммарное число ФТ и ТП не превышает 10 000, это ограничение задано программно.
2.3.2. Раздел “метрики качества”.2.3.1.11. В следующем блоке приведены метрики качества работы модели:
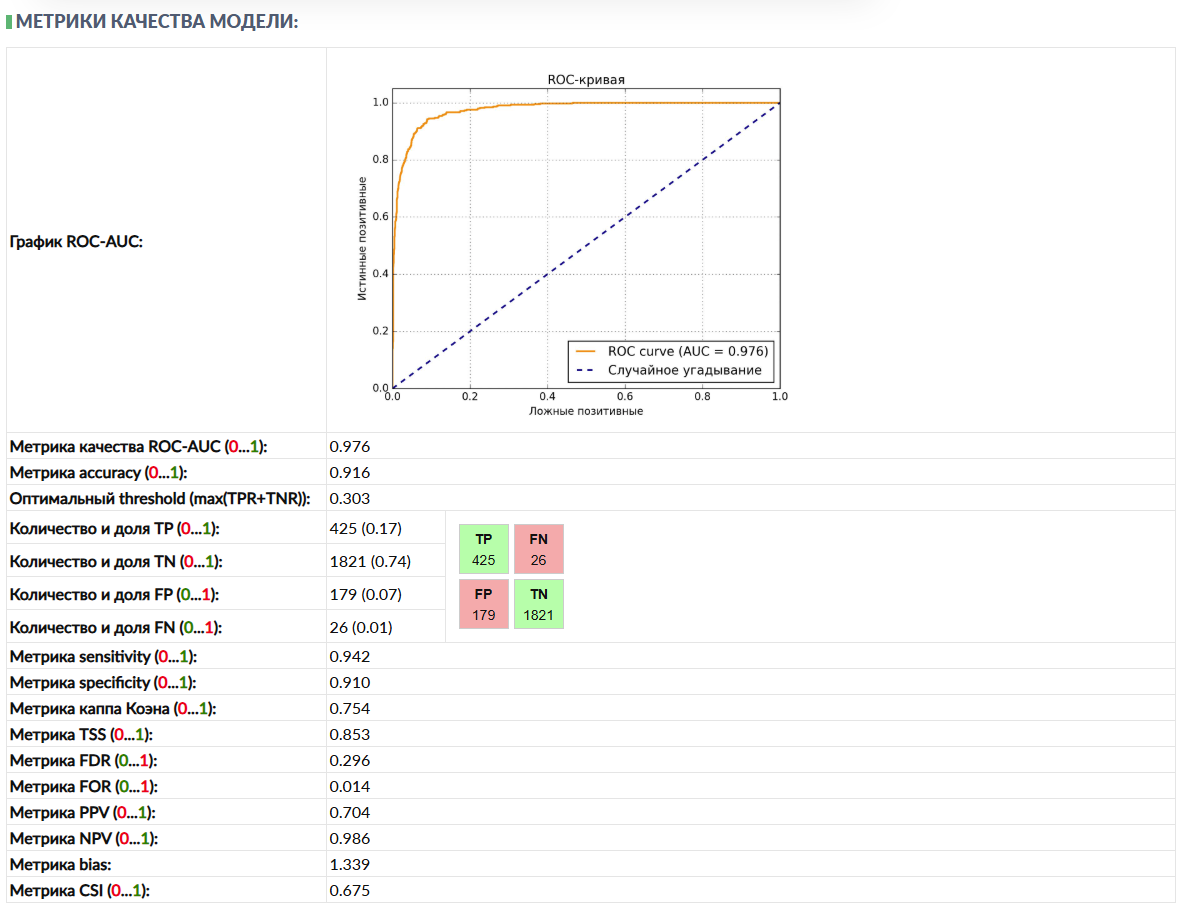
График и метрика ROC-AUC отображает зависимость между долей истинно положительных случаев (True Positive Rate, TPR, или чувствительность) и долей ложно положительных случаев (False Positive Rate, FPR) при изменении порога классификации. AUC (Area Under the Curve) — это площадь под этой кривой.
Трактовка:
- ROC-AUC = 1: Идеальная модель, которая безошибочно разделяет классы. - ROC-AUC > 0.9: Отличная модель. - 0.8 < ROC-AUC <= 0.9: Очень хорошая модель. - 0.7 < ROC-AUC <= 0.8: Хорошая модель. - 0.6 < ROC-AUC <= 0.7: Удовлетворительная модель. - 0.5 < ROC-AUC <= 0.6: Слабая модель, едва лучше случайного угадывания. - ROC-AUC = 0.5: Модель работает как случайное угадывание (для бинарной классификации). - ROC-AUC < 0.5: Модель хуже случайного угадывания (возможно, классы были перепутаны или есть серьезные проблемы).Для задач моделирования распространения видов, особенно в сложных природных условиях, значения ROC-AUC выше 0.9 считаются хорошими. Значения выше 0.95 — отличными. Все, что ниже 0.7, требует серьезного анализа и, скорее всего, изменения настроек модели и добавления наблюдательных данных.
Метрика accuracy = (TP + TN) / Total. Общая доля правильных предсказаний.
Оптимальный threshold. Результатом работы модели SDM является карта со значениями вероятности присутствия вида от 0 до 1. Однако, какое значение выбрать за порог, чтобы выше него можно было заявлять о подходящести местообитания для вида? Это расчётный показатель, максимизирующий качество долю истинных предсказаний. Для всех точек, где вероятность присутствия выше оптимального threshold, можно предполагать наличие вида.
Количество и доля True positive (TP, TPR) - число и доля точек, где вид присутствует - и модель предсказала их правильно.
TN (TNR) - число точек, где вид отсутствует, и модель предсказала отсутствие.
FP (FPR) - число точек, где вид отсутствует, но модель ошибочно предсказала его присутствие.
FN (FNR) - число точек, где вид присутствует, но модель ошибочно предсказала его отсутствие.
NB: В Qb.SDM, как и в большинстве SDM, обученных на данных только о присутствии вида, роль «отсутствия» играют фоновые точки и точки псевдоотсутствия (см. п. 2.2.6, 2.4.3) — а не подтверждённые полевые данные об отсутствии вида. Поэтому TN и FP в приведённых формулах — величины условные: «модель предсказала присутствие/отсутствие в точке, которая считается отсутствием только по построению выборки». Все метрики, использующие TN или FP (specificity, accuracy, Каппа Коэна, TSS, FOR, NPV, bias, CSI), являются приближением, а не строгой оценкой против верифицированных полевых данных об отсутствии. Пороговые шкалы интерпретации, приведённые ниже (адаптации классических градаций Свеца, 1988), изначально выводились для задач с истинными отсутствиями; для presence-background моделей максимально достижимое значение AUC/Каппа/TSS зависит от соотношения фон:присутствие и от размера региона моделирования, поэтому границу «хорошо/отлично» стоит воспринимать ориентировочно, а не как строгий норматив (подробнее об этой критике см. [13], [14]).
Метрика sensitivity = TP / (TP + FN) - чувствительность.
Метрика specificity = TN / (TN + FP) - специфичность.
Каппа Коэна измеряет степень согласия между фактическими и предсказанными присутствиями, скорректированную на согласие, которое можно ожидать случайно. Это особенно полезно, когда классы несбалансированы (мало точек наблюдений).
- Каппа = 1: Полное согласие. - 0.8 < Каппа <= 1: Почти идеальное согласие. - 0.6 < Каппа <= 0.8: Значительное согласие. - 0.4 < Каппа <= 0.6: Умеренное согласие. - 0.2 < Каппа <= 0.4: Слабое, но выше случайного согласия. - 0 < Каппа <= 0.2: Согласие, очень близкое к случайному. - Каппа = 0: Согласие идентично случайному. - Каппа < 0: Согласие хуже, чем случайное (редко, но возможно при плохой модели).Для моделирования распространения видов значения Каппа выше 0.6 считаются хорошими, а выше 0.7 — очень хорошими. Показатели выше 0.8 — отличные.
Каппа Коэна учитывает случайное совпадение, что делает его более строгой метрикой, чем простая точность (accuracy, ROC-AUC), особенно при сильном дисбалансе классов. Например, если 95% территории не пригодно для вида, модель, предсказывающая "отсутствие" для всех участков, будет иметь высокую точность (95%), но низкую Каппу.
TSS (true skills statistics) — это метрика, которая суммирует чувствительность (TPR) и специфичность (True Negative Rate, TNR). TSS = TPR + TNR - 1.
- TSS = 1: Идеальная модель (100% чувствительность и 100% специфичность). - TSS > 0.8: Отличная модель. - 0.6 < TSS <= 0.8: Очень хорошая модель. - 0.4 < TSS <= 0.6: Хорошая модель. - 0.2 < TSS <= 0.4: Удовлетворительная модель. - 0 < TSS <= 0.2: Слабая модель. - TSS = 0: Модель работает как случайное угадывание (т.е. чувствительность + специфичность = 1). - TSS < 0: Модель хуже случайного угадывания.Для моделирования распространения видов значения TSS выше 0.6 считаются хорошими, а выше 0.7 — очень хорошими. Показатели выше 0.8 — отличные. TSS очень чувствителен к тому, как модель предсказывает как положительные, так и отрицательные случаи, что делает его ценным для оценки точности предсказаний на обеих сторонах распределения.
Метрика FDR (False Discovery Rate) = FP / (TP + FP). Отражает долю ложноположительных среди всех, кого модель предсказала как положительные. Важна, когда ложное обнаружение очень дорого.
Метрика FOR (False Omission Rate) = FN / (TN + FN). Отражает долю ложноотрицательных среди всех, кого модель предсказала как отрицательные. Важна, когда пропуск истинного класса очень дорог.
Метрика PPV (Positive Predictive Value) = TP / (TP + FP). Процент истинно положительных среди всех, кого модель предсказала как положительные. Обратная к FDR.
Метрика NPV (Negative Predictive Value) = TN / (TN + FN). Процент истинно отрицательных среди всех, кого модель предсказала как отрицательные. Обратная к FOR.
Метрика bias = (TP + FP) / (TP + FN). Отношение предсказанных событий к реальным событиям:
- BS = 1 означает несмещенный прогноз (количество предсказанных положительных совпадает с количеством реальных положительных); - BS > 1 означает, что модель предсказывает больше положительных, чем их есть на самом деле (смещение в сторону положительных); - BS < 1 означает, что модель предсказывает меньше положительных, чем их есть на самом деле (смещение в сторону отрицательных).Метрика CSI (Critical Success Index) = TP / (TP + FN + FP). Отражает долю правильно предсказанных событий среди всех событий (истинных и ложных). Хорошо подходит для оценки эффективности прогнозирования редких событий.
2.3.3. Раздел “кривые откликов”.Каждый слой-предиктор в SDM характеризует одну из биогеографических переменных. Например, слой CHELSA BIO1 - среднегодовая температура в градусах. Значение задаётся для каждой точки на поверхности Земли, точнее, для сектора с площадью 30х30 угловых секунд (чуть меньше, чем 1х1 км):
Для примера возьмём регион Семиречье - он охватывает озёра Балхаш и Алаколь, а также реки, впадающие в эти озёра из горной системы Заилийского Алатау. Видно, что преобладающий цвет карты - красный. Среднегодовая температура региона, судя по шкале, от 5 до 12 градусов. Однако, есть несколько белых и даже синих областей, где среднегодовая температура ниже -10 градусов. Это ледники Тянь-Шаня, находящиеся на высотах больше 4000 метров.
Границы Семиречья в географических координатах: 73.0°E 42.0°N - 85.0°E 47.0°N. Размеры сектора - 12 градусов долготы * 5 градусов широты, или 300 * 620 угловых минут, или 600 * 1440 точек предиктора CHELSA BIO1. То есть, размер слоя BIO1 с точки зрения модели SDM = 600 * 1440 = 864 000 точек.
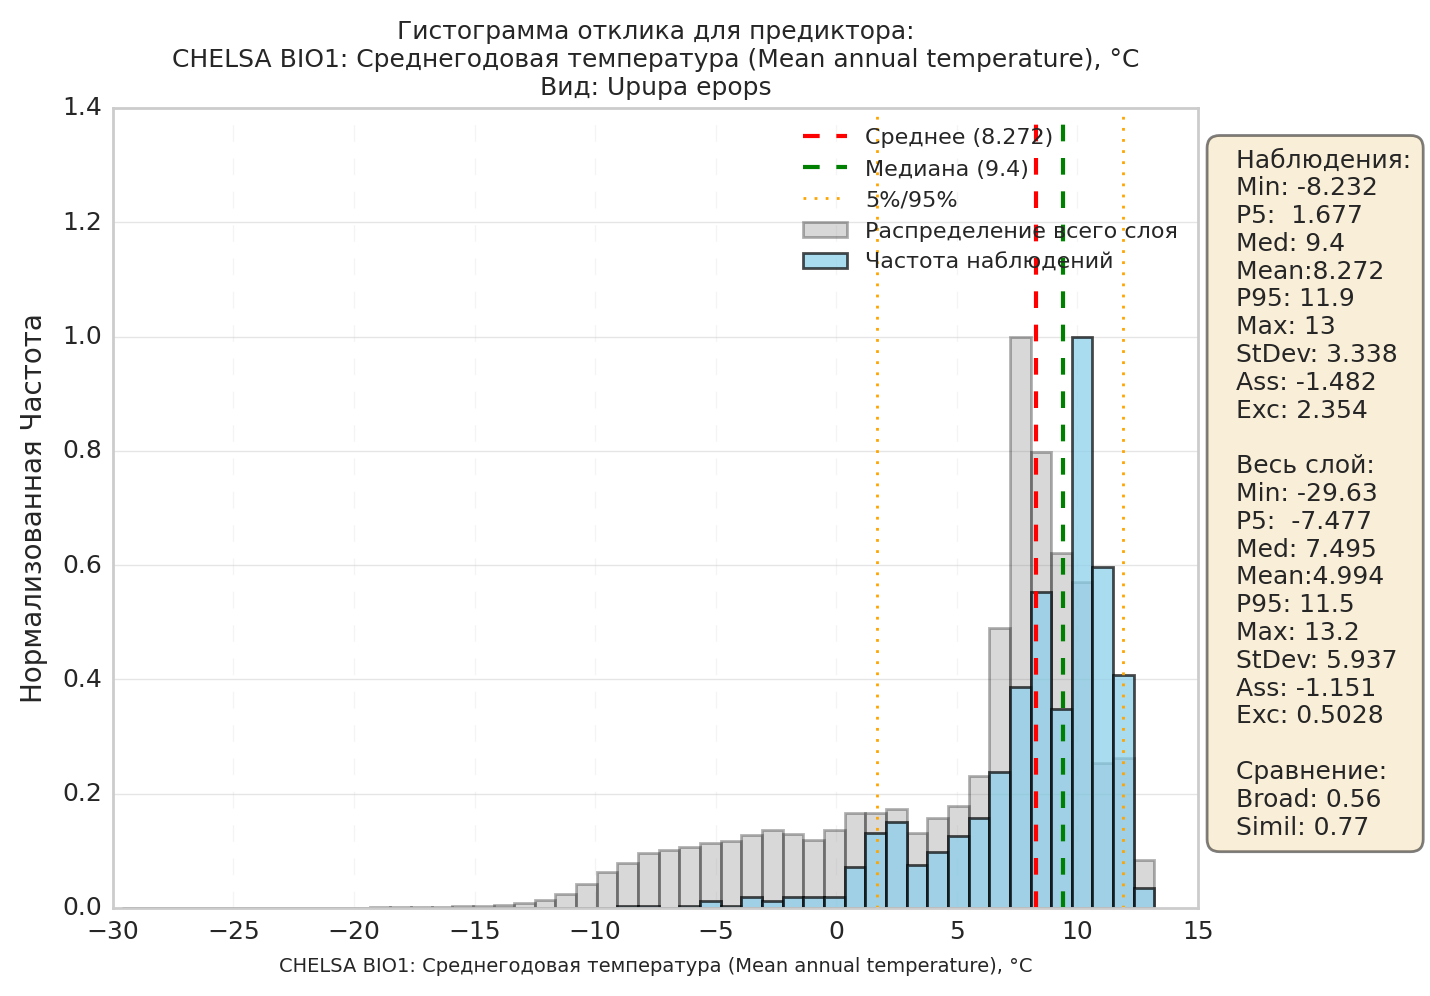
Мы можем поделить шкалу температур, например, по 1 градусу: 0-1, 1-2, 2-3, 3-4 градуса и т.д. Для каждого отрезка посчитаем количество точек, температура которых попадает в этот отрезок, например, 0-1 градуса: 2000 точек, 1-2 градуса: 2100 точек, 2-3 градуса: 2500 точек и т.д. Точное количество точек не очень интересно (оно зависит от масштаба), скорее нам нужно увидеть распределение относительно максимального числа точек.
Выполнив эту операцию для всех отрезков, мы получим гистограмму отклика для предиктора. На изображении выше это гистограмма с серой заливкой - она показывает, как значения предиктора распределены фоново, т.е. по всей области моделирования.
Дальше возьмём только те точки, где были наблюдения вида - и выполним для них аналогичную операцию. Для отрезков 0-1 градуса: 80 наблюдений, 1-2 градуса: 120 наблюдений, 2-3 градуса: 160 наблюдений и т.д. Как и в случае с фоновыми точками, точное количество нам не очень интересно, построим распределение относительно максимального числа наблюдений.
На изображении выше это гистограмма с серой заливкой - и она показывает, как распределены наблюдения вида в этом климатическом слое.
Видно, что пик “голубого” распределения приходится примерно на 10 градусов - и он правее, чем пик “серого” распределения (7 градусов). То же самое касается средних значений, они приведены в таблице справа (mean): 8.272 градуса для наблюдений и 4.994 для всего слоя.
Также видно, что для температуры ниже 0 градусов у вида практически нет наблюдений, тогда как фоновая гистограмма уходит влево сильно за 0 градусов - примерно до -15.
Сравнение гистограмм для фона и для наблюдений вида даёт информацию об экологии вида в этой области относительно этого слоя. В данном случае видно, что наш вид “не лезет” в области с низкой температурой, т.е. в горы, предпочитая равнинные и тёплые области.
Экологический смысл наиболее часто встречающихся ситуаций:
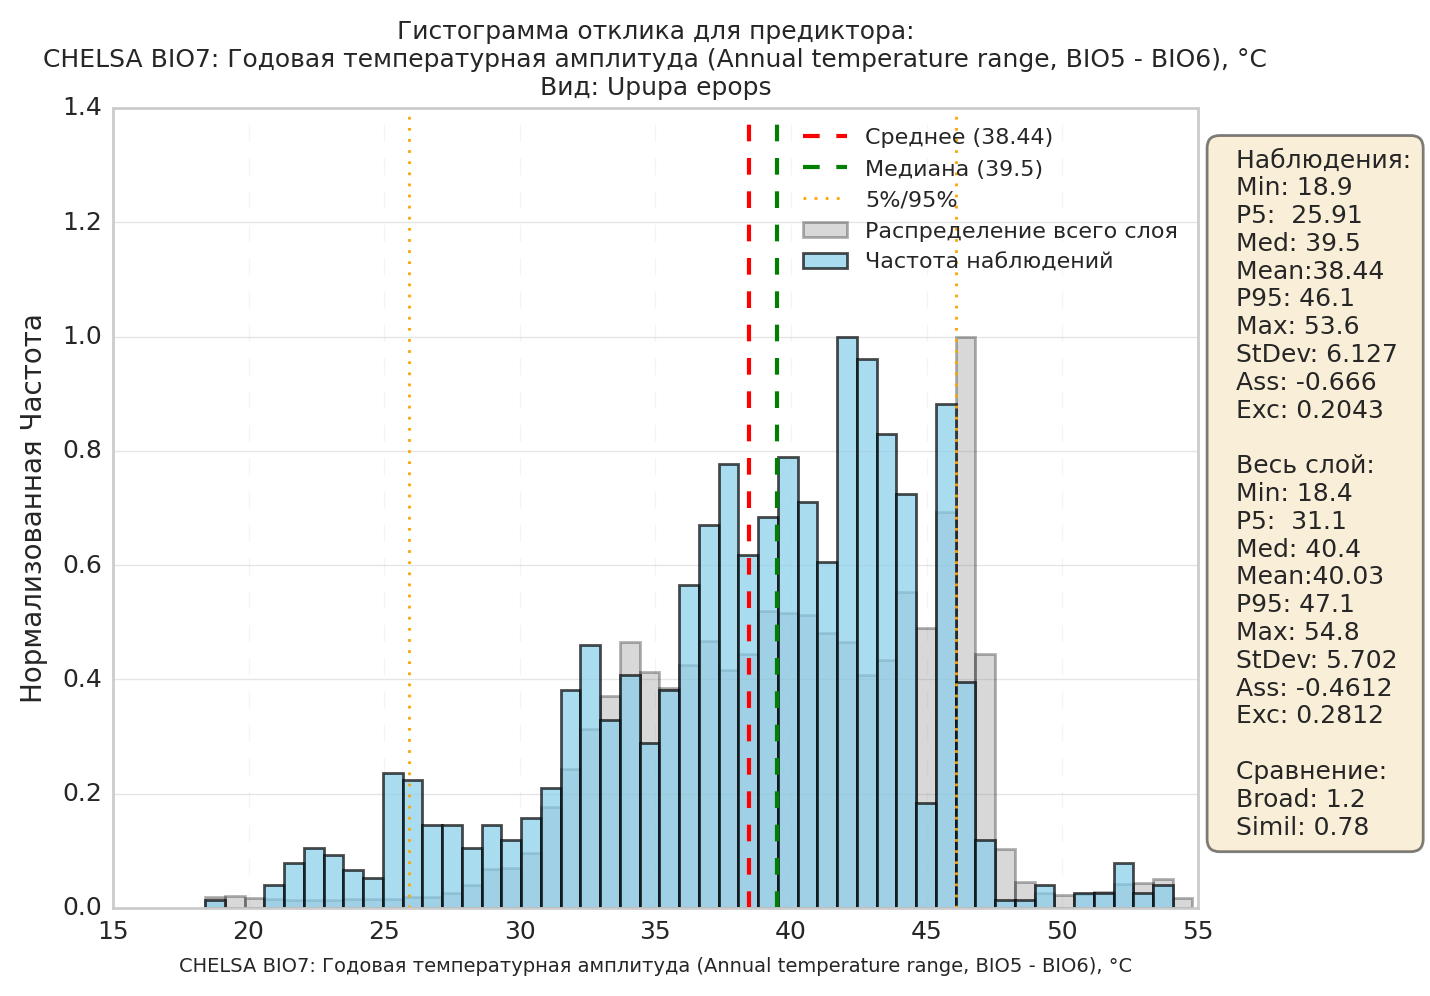
2.3.3.1. “Голубая” и “серая” гистограммы выглядят похоже во всей области присутствия (в таблице Broad и Simil близки к 1). Это значит, что условия в этом регионе по этому предиктору (“в E-пространстве”), в целом, комфортны виду.
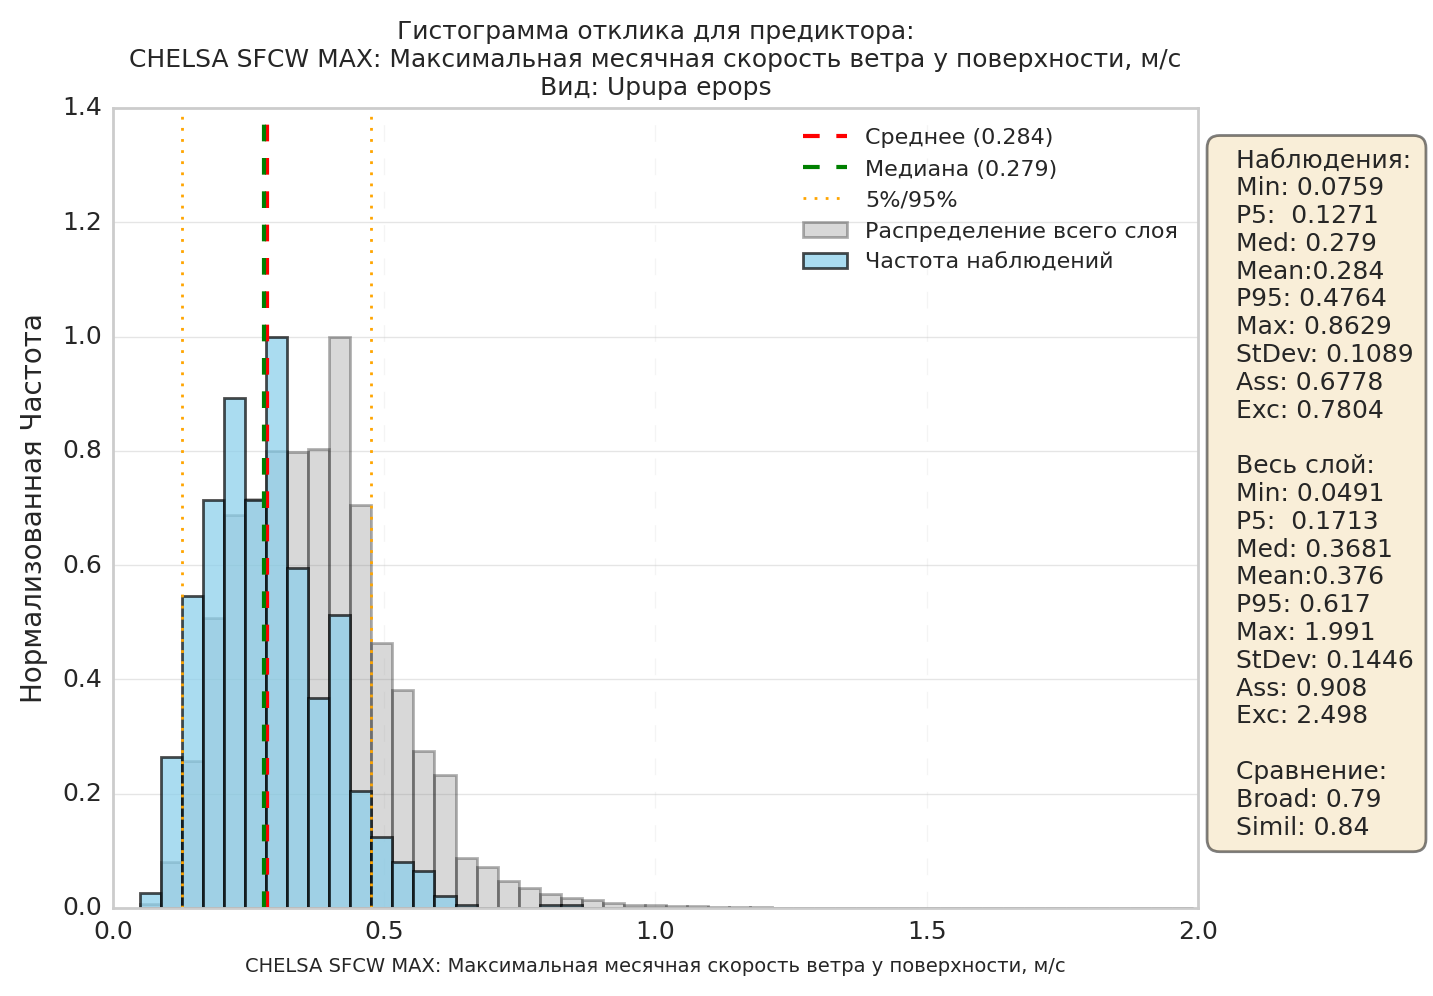
2.3.3.2. Гистограммы обе похожи друг на друга, но выглядят смещёнными (пики не совпадают). В таблице Simil близка к 1, а Med/Mean для наблюдений и всего слоя разные. Это значит, что виду комфортнее какая-то ограниченная область в этом регионе по этому слою (“в E-пространстве”). На карте это будет одна или несколько изолированных областей (“в G-пространстве”).
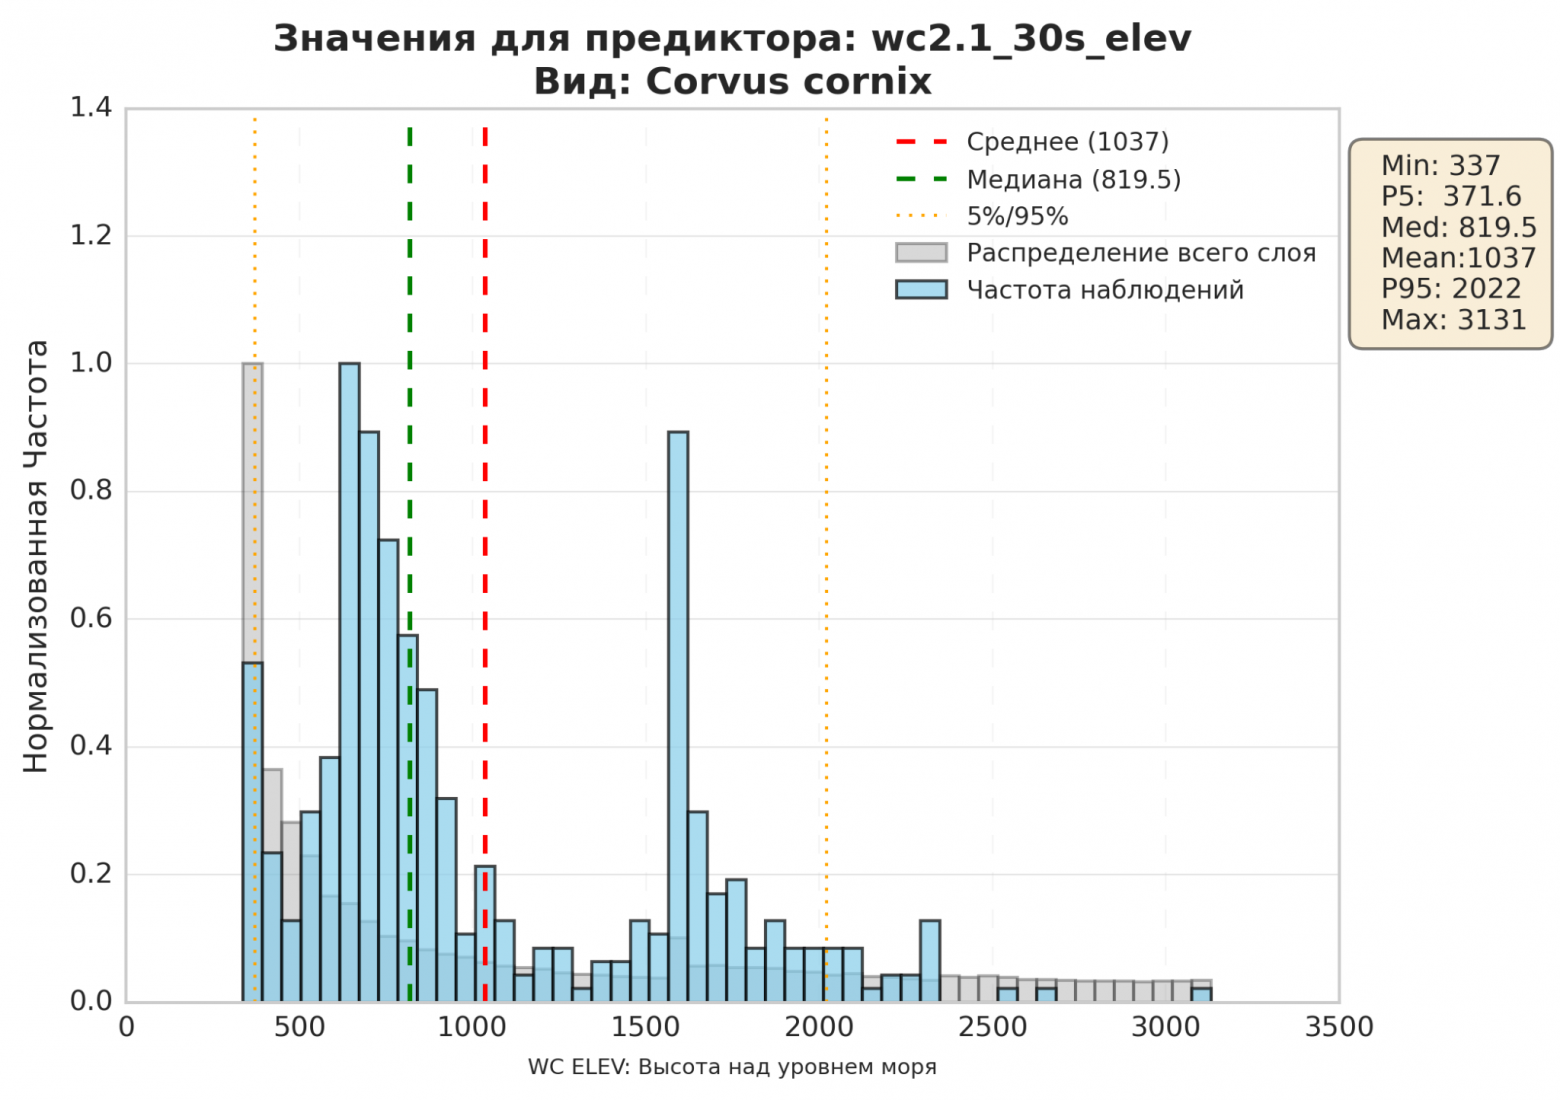
2.3.3.3. Фоновый слой (серый) распределён как “колокол” с одним пиком, а у наблюдений (голубой) есть два явных пика, находящихся на большом расстоянии друг от друга.
Фактически, на этой гистограмме изображены две разные экологические ниши, наложенные друг на друга. Такой график требует дальнейшего изучения для трактовки. Наиболее часто встречающиеся ситуации:
- мы видим сезонную миграцию или кочёвку вида в пределах области моделирования. Летом вид живёт в одной области, зимой - в другой; - на графике две разные популяции, приспособившиеся к разным условиям. Например, в результате отбора в модель попало два разных вида. Или два разных подвида (популяции) одного вида, обитающих в разных условиях - вероятно, в процессе формирования видовой изоляции.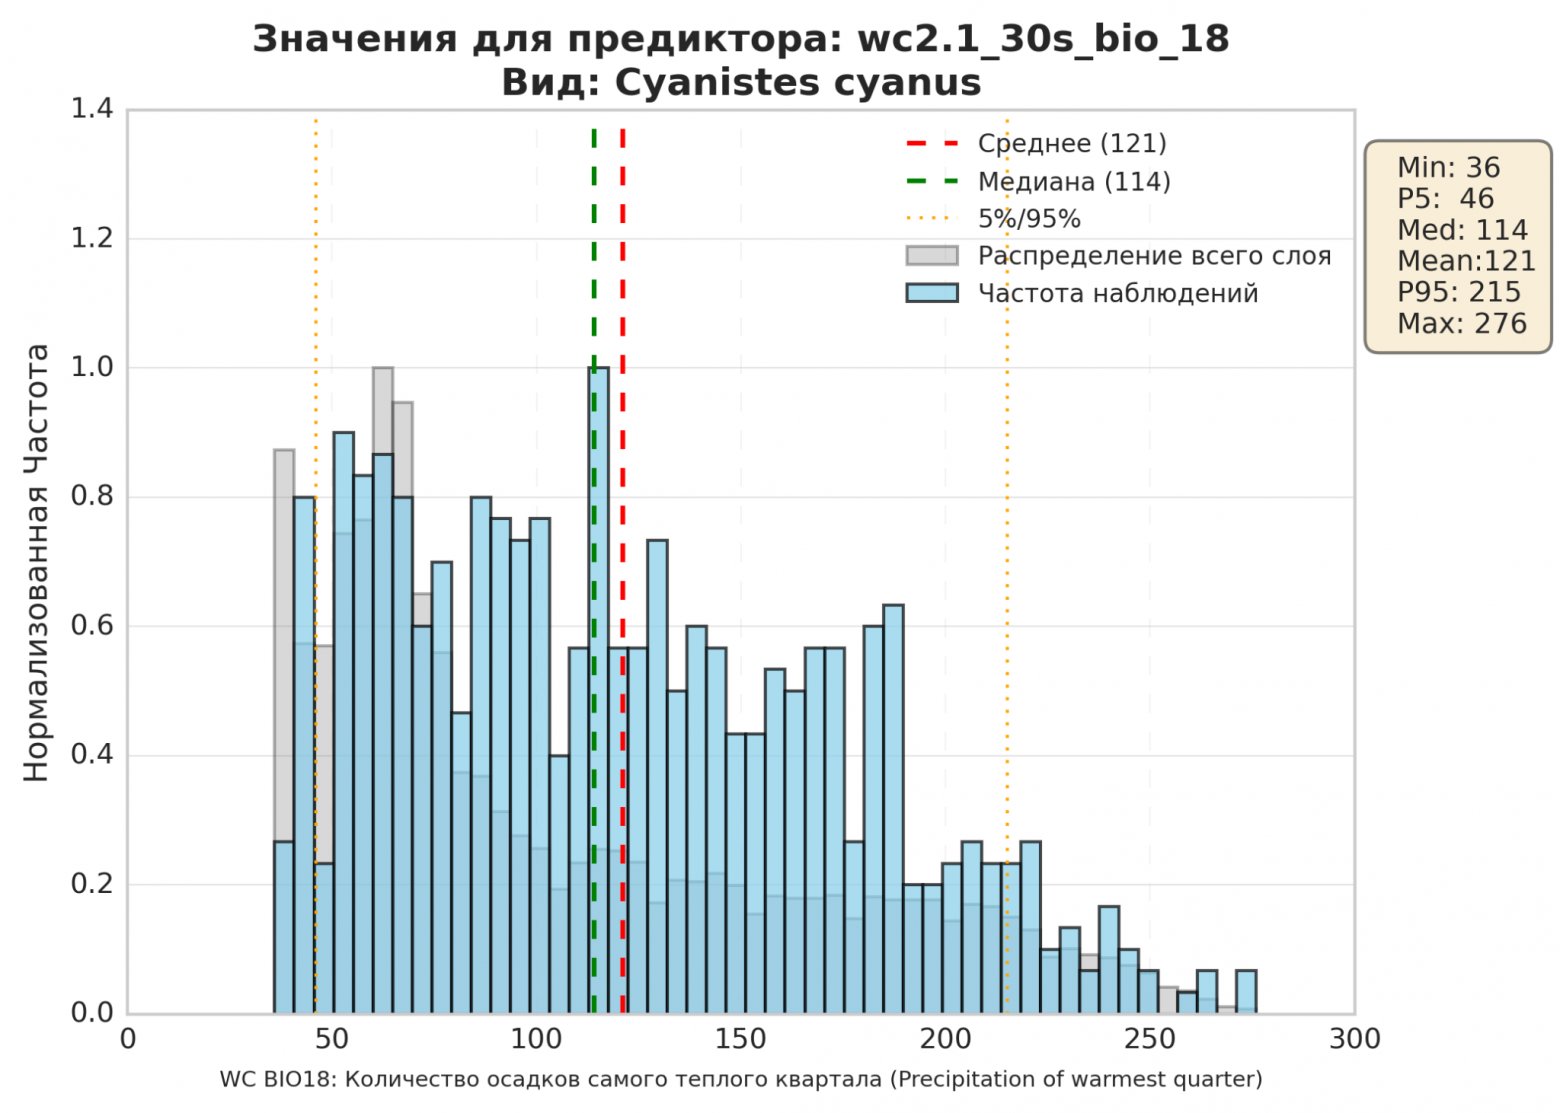
2.3.3.4. Гистограмма равномерно “размазана” по всем значениям. Экологический смысл такого графика - вид от этого фактора практически не зависит. Ему комфортно при любом количестве осадков, если только их не больше ~200 мм в квартал.
Описание значений из таблицы справа от гистограммы:
- “наблюдения” - верхняя половина таблицы статистически описывает встречи вида (голубую гистограмму), “весь слой” описывает моделируемый регион в целом (серую гистограмму); - min и max - минимальное и максимальное значение предиктора (в этом примере минимальная температура, где встречался вид Min=-8.232 градуса, в то время как во всём слое Min=-29.63 градуса, а вот по максимальным температурам наблюдения и слой почти совпали); - P5, P95 - значения, в которые попадает >5% и <95% всех точек (в этом примере P5 для наблюдений это 1.677 градуса, а для всего слоя P5=-7.477 градуса, т.е. вид не любит холодные регионы); - Med - медиана, Mean - среднее значение; - StDev - стандартное отклонение (среднеквадратичное). Большее значение среднеквадратического отклонения показывает больший разброс значений в представленном множестве со средней величиной множества; меньшее значение, соответственно, показывает, что значения в множестве сгруппированы вокруг среднего значения; - Ass - коэффициент асимметрии. Положителен, если правый хвост распределения длиннее левого, отрицателен в противном случае. Для симметричных графиков равен нулю; - Exc - коэффициент эксцесса. Мера остроты пика распределения случайной величины; - в блоке “сравнения” приведены статистические меры, сравнивающие две гистограммы (голубую и серую) друг с другом; - Broad - относительная ширина гистограмм, чем ближе к 1 - тем ближе ширина гистограмм друг к другу; - Simil - коэффициент подобия (корреляции) гистограмм, где 1 - прямая пропорциональность. 2.3.4. Раздел “важность предикторов”.Не все предикторы (биоклиматические переменные) одинаково важны для прогнозирования присутствия вида.
Например, для околоводных видов одним из наиболее важных предикторов будет близость к водоёмам. Если запустить модель без предиктора “расстояние до водоёмов”, скорее всего, качество (точность) модели резко снизится.
И наоборот, для видов пустыни будут практически не важными предикторы, показывающие степень покрытия лиственными или хвойными деревьями. Если запустить модель без них, её качество почти не изменится.
Модель SDM позволяет рассчитать параметр важности для каждого предиктора. Принцип рассчёта следующий: модель смотрит, насколько сильно изменение этого предиктора влияет на изменение итогового результата.
Важность предиктора - ещё одна мера, позволяющая сделать выводы об экологии вида:
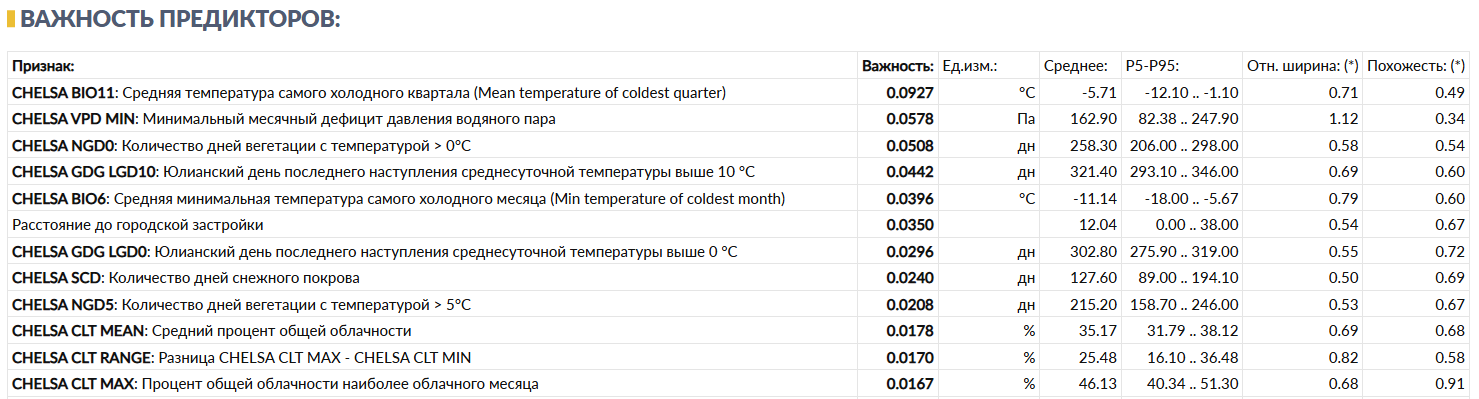
В данном примере видно, что самый важный предиктор для моделируемого вида (удод Upupa epos) - BIO11, средняя температура самого холодного квартала. Этот вид не может выживать в регионах со слишком низкой зимней температурой.
Обратите внимание, что на втором и третьем местах по важности здесь находятся предикторы, не влияющие на этот вид непосредственно. Они влияют на распространение вида косвенно, например, через трофические цепочки (удод - насекомоядная птица).
NB: Важно понимать ограничения этой метрики. У RandomForest, XGBoost и MaxEnt разные математические определения важности (для деревьев решений — вклад предиктора в снижение неопределённости при разбиениях, для MaxEnt — вес признака после регуляризации), поэтому напрямую сравнивать проценты важности одного и того же предиктора между разными моделями нельзя. Во-вторых, если два предиктора сильно скоррелированы между собой (например, среднегодовая температура и температура самого тёплого месяца), модель может «поделить» важность между ними произвольным образом — низкая важность конкретного слоя в этом случае не обязательно означает, что соответствующий экологический фактор не важен для вида, а может означать, что его роль в модели взял на себя коррелирующий с ним предиктор.
Остальные цифры в таблице важности предикторов совпадают с цифрами из гистограмм отклика, см. п. 2.3.3.
2.3.5. Раздел карт.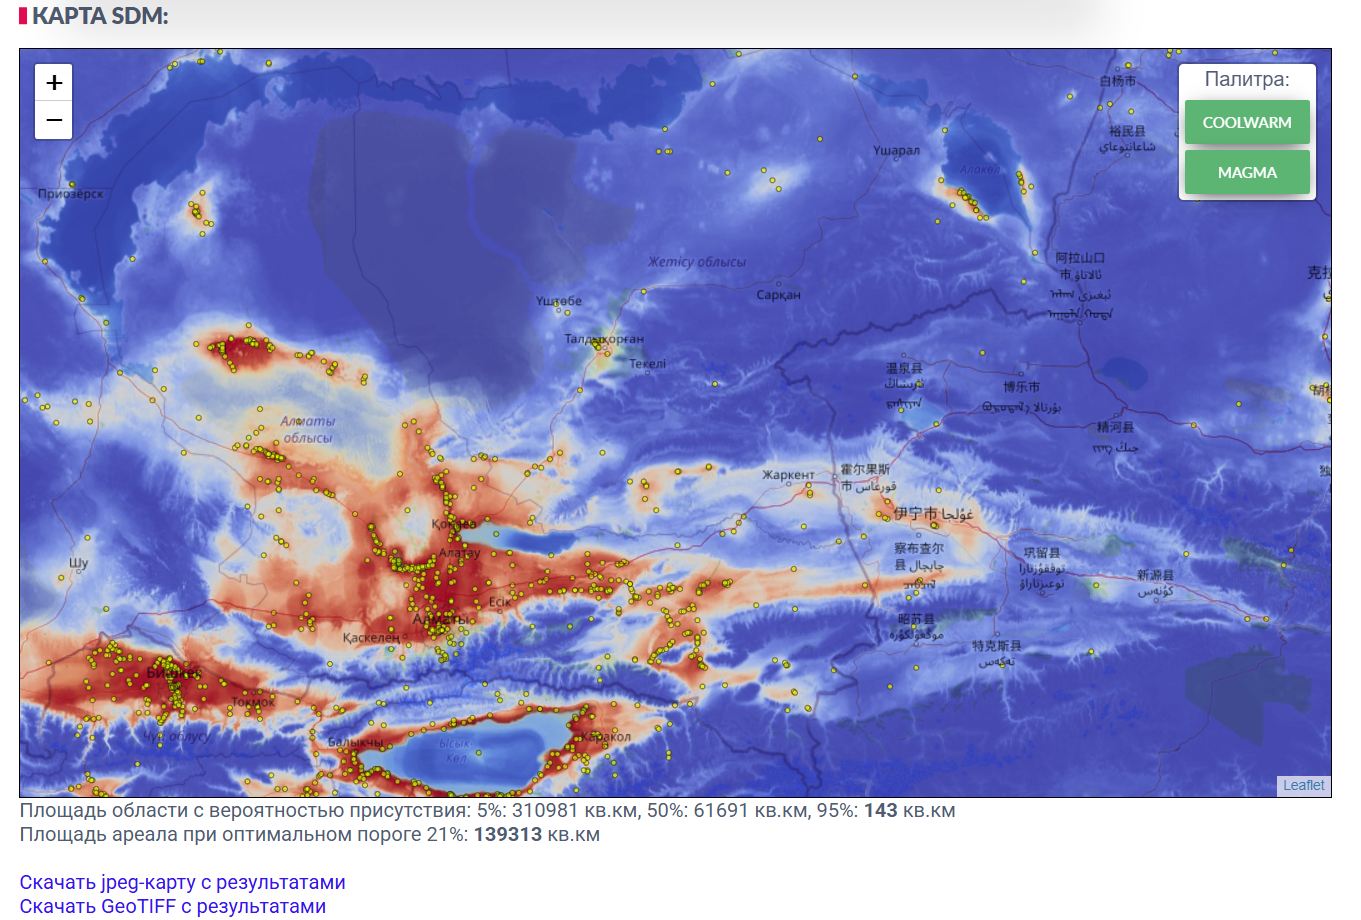
Карта - это результат проекции E-пространства (подходящих экологических ниш) в G-пространство (географическое).
Во многих работах по SDM результат работы называется вероятностью присутствия вида, однако, с экологической точки зрения это неверно. Смысл карты - подходящие местообитания (с точки зрения модели и загруженного в неё набора предикторов).
Синим цветом выделены области, где условия не подходят для вида (подходящесть 0%). Красным - подходят наилучшим образом (100%).
Жёлтыми круглешками отмечены наблюдения вида, поданные на вход модели.
Обратите внимание, что ряд жёлтых меток находится в синей области. Это могут быть как ошибки модели (систематические), так и ошибочные наблюдения. В ряде случаев вид может наблюдаться вне пределов подходящих местообитаний, например, при миграции или бегстве от хищника.
Может быть и обратная ситуация, когда в красных областях нет отметок. Возможные причины, кроме неточности модели: в этой местности не было наблюдателей, знающих этот вид. Либо вид не может попасть в эту местности из-за каких-то ограничений (например, переплыть море или преодолеть горную систему).
Подробнее см. раздел 1.2.
Обратите также внимание на результат “площадь ареала при оптимальном пороге”. Значение порога - это отсечка вероятности, при которой модель показывает максимальную предсказательную способность. Т.е. наиболее вероятно, что взяв точки с порогом выше этого, мы получим площадь ареала вида.
TODO: Карты будущего и прошлого, месячные карты.
2.4. Qb.SDM: техническое описание алгоритмов:Актуальный исходный код Qb.SDM представлен на Github по ссылке https://github.com/mad-kiba/python-sdm/. Если вы хотите воспроизвести алгоритм или установить систему Qb.SDM на собственном компьютере, в документации на Github приведена подробная инструкция, как это сделать. Также вы можете использовать Qb.SDM как подключаемый модуль в собственных решениях, при условии упоминания адреса Github.
Общее описание алгоритма Qb.SDM представлено в пункте 2.4.5.
2.4.1. Предварительная подготовка наблюдений. 1. Если в файле есть колонка species, и значения в ней одинаковые - модель из неё определяет название вида. 2. Если в файле есть колонки kingdom и class, и значения в каждой из них одинаковые - модель из них определяет название царства и класса, которые используются для вычисления точек псевдоотсутствия вида, см. 2.4.3. 3. Для координат используются колонки с названиями lat, lon. Если таких колонок в файле нет, то пары Latitude/Longitude, latitude/longitude, decimalLatitude/decimalLongitude. 4. Из выборки удаляются наблюдения, для которых задано поле coordinateUncertaintyInMeters и его значение больше 1000 метров (т.к. минимальный шаг модели = 30 угловым секундам, что примерно 1х1 км). 5. Из выборки удаляются наблюдения, для которых collectionCode = EOA (для этой коллекции в GBIF опубликованы данные с некорректными координатами). 6. Из выборки удаляются наблюдения без указанного года, а также сделанные раньше 2000 года. 7. Если в выборку попало менее 10 точек - модель завершает работу. 8. Удаляются все наблюдения, попавшие в эту область растра, кроме одной - дедупликация. 9. Если после дедупликации осталось менее 5 уникальных точек - модель также завершает работу. Эта проверка отдельная от п.7: несколько исходных наблюдений могут попасть в один и тот же пиксель растра (особенно при крупном шаге модели, например 5’), и после дедупликации уникальных точек может оказаться заметно меньше, чем было записей в исходном файле. 2.4.2. Предварительная подготовка предикторов.Целевая проекция CRS - EPSG:4326 - географическая система координат, основанная на эллипсоиде WGS 84, где положение точек определяется широтой и долготой в десятичных градусах.
Если проекция предиктора отличается от EPSG:4326, производится репроекция.
Для работы алгоритмов машинного требуется два вида точек:
- точки, где вид присутствует; - точки, где вид отсутствует.На основании этих точек алгоритм учится предсказывать, насколько условия в любой точке карты подходят для первого или второго класса, т.е. насколько вероятна встреча вида в этой точке.
С точками присутствия вида всё довольно просто - это наблюдательные данные, ваши, из GBIF - или из любых других источников. Главное требование к наблюдательным данным, по сути, чтобы их пространственное разрешение было выше, чем разрешение слоёв-предикторов. С наличием GPS в большинстве современных смартфонов это требование выполняется с большим запасом.
С точками отсутствия дело обстоит заметно сложнее. Технически в GBIF можно занести точки отсутствия вида, однако, на практике доля таких точек составляет примерно 0.01% - и они есть даже не для каждого класса животных или растений.
За исключением тривиальных случаев (“рыбы живут в водоёмах”), довольно тяжело дать гарантии, что вид не встречается в данной точке (т.е. на участке 1х1 км). Особенно если он встречается в соседних точках.
Проблема настолько серьёзная, что долгое время лидирующим алгоритмом для SDM был метод MaxEnt - с довольно посредственным качеством, но не требующий точек отсутствия вида теоретически. Однако, у MaxEnt есть и другие недостатки, например, запрет на коллинеарность предикторов.
В результате появилось несколько алгоритмов, позволяющих сгенерировать точки “отсутствия” вида статистическими методами. Из них два основных:
- метод фоновых точек; - метод точек псевдоотсутствия.2.4.3.1. Метод фоновых точек. Метод достаточно тривиальный, его суть в том, что точки “отсутствия” вида берутся по всему региону в случайном порядке (фоново), за исключением точек присутствия.
Кажется, что метод должен быть не очень точным, однако, в большинстве случаев он обеспечивает точность выше, чем MaxEnt с аналогичными входными данными. И чем больше разрешение модели, тем больше доля точек, где вида нет на самом деле.
2.4.3.2. Метод точек псевдоотсутствия (RSEB):
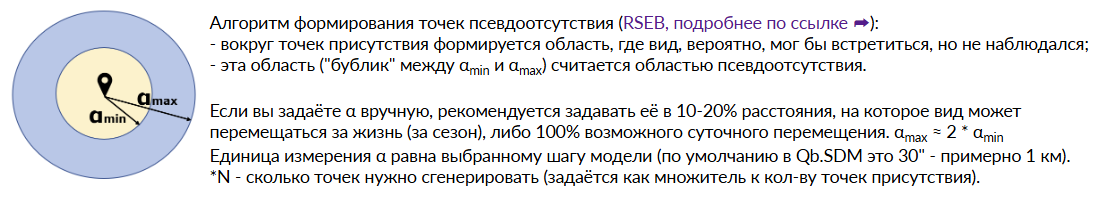
Вокруг всех точек присутствия формируется область, где вид, вероятно, мог бы встретиться, но не наблюдался. Эта область (“бублик” между αmin и αmax) считается областью псевдоотсутствия.
Рекомендуется задавать область αmin, αmax-αmin в 10-20% расстояния, на которое вид может перемещаться за жизнь (за сезон), либо 100% возможного суточного перемещения. Обычно αmax = 2 * αmin. Подробнее см. [11], [12].
Метод точек псевдоотсутствия значительно повышает качество модели, однако, его использование требует знания биологии вида.
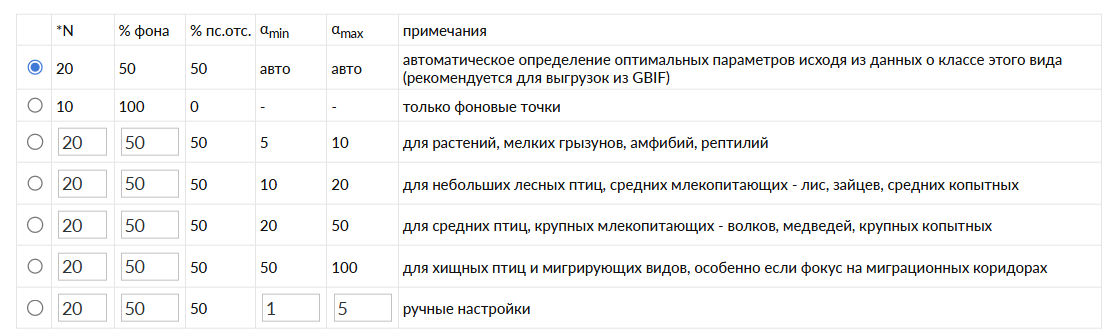
В систему Qb.SDM внесены усреднённые значения αmin и αmax для разных классов животных и растений. Однако, если у вас есть возможность уточнить эти данные для целевого вида, рекомендуется это сделать.
По умолчанию система пытается автоматически определить класс животного и подходящее для него значение Amin и Amax. Далее генерируется одинаковое количество фоновых точек и точек псевдоотсутствия. Количество тех и других определяется как 10 * число уникальных точек присутствия, но не более 10 000 суммарно.
Для первого запуска вы можете положиться на этот алгоритм (первый пункт в списке “авто”), либо выбрать один из типовых наборов параметров. Также возможно полностью ручное управление этими параметрами.
2.4.4. Учёт фактора мобильности вида (М-фактор).Помимо статистической модели пригодности местообитания (абиотическая компонента, «A» в фреймворке BAM — Biotic-Abiotic-Movement, Soberón & Peterson), Qb.SDM реализует упрощённый учёт компоненты подвижности («M» — Movement): физической способности вида достичь пригодной территории.
Расчёт выполняется как построение поля «стоимости пути» (cost-distance) от точек присутствия вида по всей карте: скорость перемещения по каждой точке зависит от уклона местности, наличия высотных барьеров и водных преград. Полученное поле переводится в множитель от 0 (недостижимо) до 1 (совпадает с точкой наблюдения), которым домножается карта пригодности:
итоговая карта пригодности = (абиотическая пригодность, из статистической модели) × (М-фактор, из поля доступности).
NB: Это не полноценная механистическая модель расселения, а эвристическое приближение: параметры по умолчанию (дистанция расселения, высотный барьер, крутизна штрафа за уклон) заданы усреднённо по классу/царству вида и могут не отражать особенности конкретного вида или региона. При наличии данных о биологии вида рекомендуется задавать эти параметры вручную (см. п. 2.2.10).
2.4.5. Описание работы модели.Общая последовательность этапов:
1. Подготовка слоёв-предикторов, приведение к единому разрешению и формату, стандартизация слоёв. 2. Загрузка наблюдений. 3. Первичная фильтрация наблюдений. 4. Загрузка предикторов. 5. Проекция наблюдений на предикторы, вычисление биогеографических переменных в точках наблюдений. 6. Дедупликация наблюдений по пикселю растра (предикторов). 7. Генерация фоновых точек и точек псевдоотсутствия. 8. Постройка гистограмм отклика. 9. Обучение модели. 10. Вычисление метрик качества модели. 11. Применение модели к каждой точке растра для статических предикторов + предикторов настоящего времени. Постройка карты присутствия вида. 12. >> для статических предикторов + предикторов будущего времени. Карты. 13. >> для статических предикторов + помесячных предикторов. Карты. 14. Сохранение результатов, демонстрация пользователю.Подробный онлайн курс по SDM/ENM от авторов метода:
https://www.youtube.com/playlist?list=PLCq9UxocboXPdulJteLT7MYj1WrW_tKcd
Описание и программа курса: Peterson A. et al. ENM2020: A FREE ONLINE COURSE AND SET OF RESOURCES ON MODELING SPECIES NICHES AND DISTRIBUTIONS. https://doi.org/10.17161/bi.v17i.15016
Другие использованные источники:
1. A. Townsend Peterson & Jorge Soberón. Species Distribution Modeling and Ecological Niche Modeling: Getting the Concepts Right. https://doi.org/10.4322/natcon.2012.019
2. Brun, P., Zimmermann, N. E., Hari, C., Pellissier, L., Karger, D. N. (2022). CHELSA-BIOCLIM+ A novel set of global climate-related predictors at kilometre-resolution. EnviDat. https://www.doi.org/10.16904/envidat.332 https://www.chelsa-climate.org/
3. Khondamir Rustamov. Comparison of different models in predicting habitat suitability of rare species in Uzbekistan: 8 rare Tulipa species case-study. https://doi.org/10.1101/2022.07.08.499262
4. Karger, D. N., Nobis, M. P., Normand, S., Graham, C. H., and Zimmermann, N. E.: CHELSA-TraCE21k – high-resolution (1 km) downscaled transient temperature and precipitation data since the Last Glacial Maximum, Clim. Past, 19, 439–456, https://www.chelsa-climate.org/datasets/chelsa-trace21k-centennial-bioclim
5. WorldClim 2.1. Fick, S.E. and R.J. Hijmans, 2017. WorldClim 2: new 1km spatial resolution climate surfaces for global land areas. International Journal of Climatology 37 (12). https://www.worldclim.org/data/worldclim21.html
6. ENVIREM. Title P.O., Bemmels J.B. 2018. ENVIREM: an expanded set of bioclimatic and topographic variables increases flexibility and improves performance of ecological niche modeling. Ecography. 41:291–307. https://envirem.github.io/
7. EarthEnv Land Cover. Tuanmu, M.-N. and W. Jetz. 2014. A global 1-km consensus land-cover product for biodiversity and ecosystem modeling. Global Ecology and Biogeography 23(9): 1031-1045. https://www.earthenv.org/landcover
8. SoilGrids. Common soil chemical and physical properties: Poggio, L., de Sousa, L. M., Batjes, N. H., Heuvelink, G. B. M., Kempen, B., Ribeiro, E., and Rossiter, D.: SoilGrids 2.0: producing soil information for the globe with quantified spatial uncertainty, SOIL, 7, 217–240, 2021. https://docs.isric.org/globaldata/soilgrids/
9. The Shared Socioeconomic Pathways and their energy, land use, and greenhouse gas emissions implications: An overview. Keywan R. et al. https://doi.org/10.1016/j.gloenvcha.2016.05.009
10. Global climate-related predictors at kilometer resolution for the past and future/ Philipp Brun et al. https://doi.org/10.5194/essd-14-5573-2022
11. Pseudo-absence and background data. Damaris Zurell, 2022.
https://damariszurell.github.io/EEC-MGC/b5_pseudoabsence.html
12. Selecting pseudo-absences for species distribution models: how, where and how many? Morgane Barbet-Massin et al. https://doi.org/10.1111/j.2041-210X.2011.00172.x
13. Lobo, J.M., Jiménez-Valverde, A., Real, R. (2008). AUC: a misleading measure of the performance of predictive distribution models. Global Ecology and Biogeography, 17(2), 145-151. https://doi.org/10.1111/j.1466-8238.2007.00358.x
14. Jiménez, L., Soberón, J. (2020). Leaving the area under the receiving operating characteristic curve behind: An evaluation method for species distribution modelling applications based on presence-only data. Methods in Ecology and Evolution, 11(12), 1571-1586. https://doi.org/10.1111/2041-210x.13479
Примеры моделей и наборов данных, упоминаемых в документации:
G1. https://www.gbif.org/species/2487877


